Prompts para MiniMax H3 en series cortas: la misma cara y la misma voz en cada clip
 Chywe, responsable de producto en HelloGen
Episodio uno: tu protagonista tiene barba corta y una chaqueta verde. Episodio tres: sin barba, con un abrigo gris y una voz una octava más aguda. Si haces series cortas con IA, ya sea un microdrama con personajes realistas o una frutinovela, esto te sonará. MiniMax H3 (Hailuo 3.0) puede mantener al mismo personaje de un clip a otro (admite hasta nueve imágenes de referencia y genera las voces sincronizadas con la imagen), pero solo si el prompt sigue el formato que el modelo sabe interpretar. Cuando un personaje cambia, casi siempre es por una de estas tres cosas: las imágenes están adjuntas pero el prompt nunca las nombra, las frases quedan fuera de los marcadores de diálogo de H3 o el personaje se vuelve a describir en cada plano, cada vez de forma un poco distinta. Esta guía de prompts para MiniMax H3 resuelve las tres a partir de las reglas oficiales de MiniMax y de lo que medimos en nuestras propias pruebas con H3. Todos los clips de esta página se generaron en HelloGen; el prompt completo de la escena del café está más abajo.
✦ Prueba MiniMax H3 Unlimited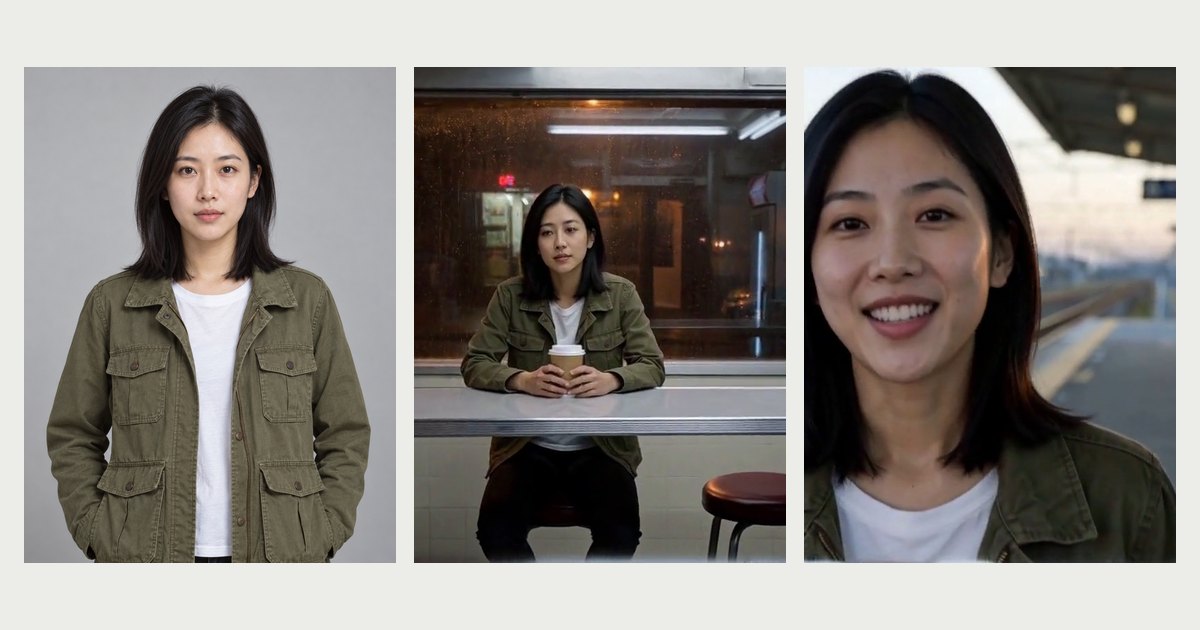
Ya subí una imagen de referencia, ¿por qué mi personaje de MiniMax H3 sigue cambiando?
Respuesta corta: adjunta la misma imagen de referencia a cada clip, vincúlala a una etiqueta (<Subject 1> is the woman in <Picture 1>), indica una sola vez en retention_analysis qué hay que conservar, pon cada frase dentro de <d>…</d> con un ID de hablante y pega la misma descripción de voz en cada clip. Más abajo lo explicamos paso a paso.
Cada clip se genera por separado. Cuando H3 genera el episodio dos, no recuerda nada del episodio uno, así que todo lo que un clip sabe sobre quién aparece en pantalla sale de tres fuentes, y de ninguna más: la imagen de referencia que adjuntas, las etiquetas del prompt que vinculan esa imagen con un personaje y las palabras que escribes sobre ese personaje. Si una cara cambia, es que falta una de las tres o que dos se contradicen.
El caso más común es fácil de pasar por alto: como las imágenes ya están adjuntas, el prompt parece terminado, pero nada le indica al modelo a quién corresponde cada imagen. Encima, los planos vuelven a describir a la persona con palabras, así que el modelo recibe dos descripciones que compiten entre sí: la imagen, que ya muestra a esa persona, y el texto.
| De dónde sale la identidad | Qué aporta | Qué pasa si falta |
|---|---|---|
| La imagen de referencia | Cara, pelo, complexión, ropa | El modelo inventa a una persona nueva en cada clip |
| La etiqueta que la vincula (<Subject 1> … <Picture 1>) | Qué imagen corresponde a qué personaje | Las caras se intercambian o dos personajes se funden en uno |
| Las palabras sobre el personaje | Lo que hace, dice y siente en esta escena | Si vuelven a describir su aspecto, se imponen a la imagen y los detalles cambian |
Paso 1: Primero el reparto, con una imagen de referencia por personaje
El flujo de trabajo que propone MiniMax para cortometrajes empieza aquí, antes de generar ningún vídeo: una ficha de personaje por cada persona y una ficha de escenario por cada locación, que muestra solo el lugar, sin gente (3d-animation-short-generator en GitHub). El motivo sirve para cualquier modelo: una imagen conserva una cara mejor que un párrafo.
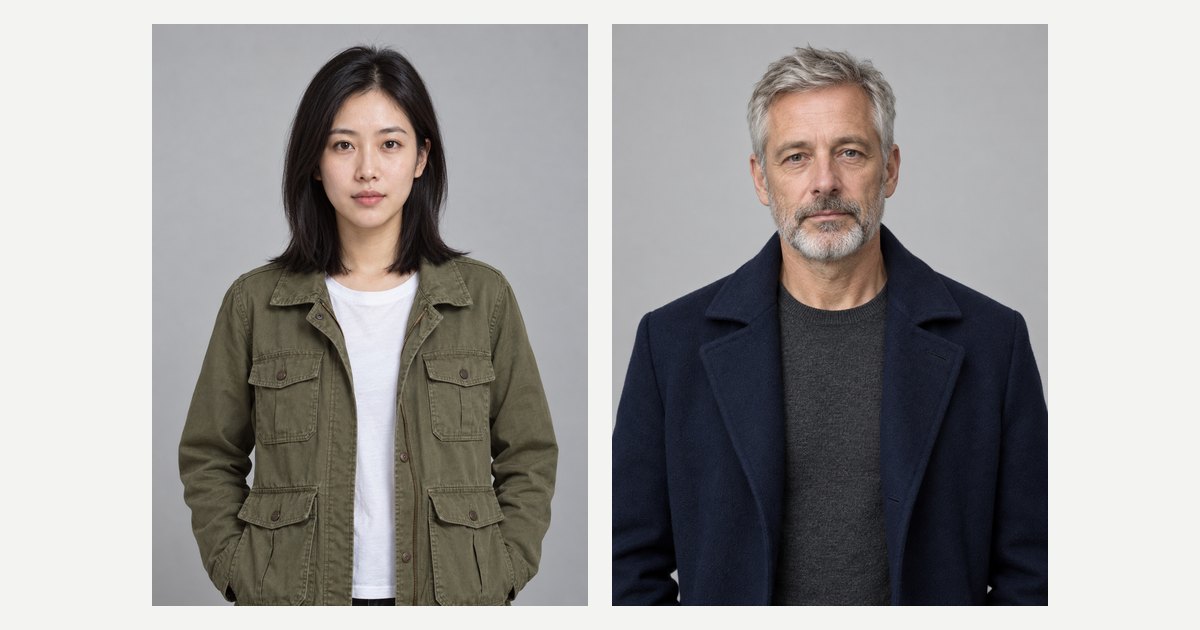
Así es una buena imagen de referencia de personaje para H3:
- Un personaje por imagen: de la cintura para arriba, mirando a cámara, con fondo liso y luz uniforme, como los dos retratos de abajo.
- Que la cara se vea grande. En H3 Unlimited de HelloGen, cada referencia se reescala al tamaño del lienzo del clip antes de que el modelo la vea, así que una cara pequeña en una foto de plano general, o en una lámina con muchas vistas del personaje, llega convertida en un puñado de píxeles. Un encuadre de cintura para arriba muestra la ropa y deja la cara a buen tamaño.
- La ropa va en la imagen, no en el prompt. Si tu protagonista lleva la chaqueta verde en todos los episodios, genera su imagen con la chaqueta verde puesta. Un cambio de vestuario a mitad de la serie requiere una imagen nueva, no una frase nueva.
- Usa el mismo archivo en toda la serie. Una imagen un poco distinta es una persona un poco distinta.
Puedes crear tu reparto con el generador de imágenes gratis de HelloGen, guardar las imágenes y adjuntar esos mismos archivos a cada clip.
Paso 2: Vincula cada imagen a un personaje con <Subject N>
El modo de referencia de H3 (en el generador de vídeo de HelloGen se llama «Referencia Omni») tiene sus propias etiquetas, y son justo lo que la mayoría de los prompts se salta. La guía de MiniMax usa <Picture N> para la imagen en sí y <Subject N> para algo que se toma de ella (una persona, un atuendo, un lugar) y que luego los planos pueden mencionar (h3-prompt-writing en GitHub). Para H3, un personaje es un sujeto (Subject):
<Subject 1> is the young woman in <Picture 1>, with shoulder-length black hair and a green field jacket.
En español: <Subject 1> es la joven de <Picture 1>, con el pelo negro a la altura de los hombros y una chaqueta verde.
A partir de ahí, todos los planos dicen «<Subject 1>», nunca «she» (ella) ni «the girl» (la chica): cada etiqueta significa una sola cosa en todas las secciones del prompt. La descripción que identifica al personaje debe ser corta y conviene repetirla con exactamente las mismas palabras: los propios ejemplos de MiniMax repiten «the young man in the dark-grey hoodie» (el joven de la sudadera gris oscuro) plano tras plano, sin buscar sinónimos. En HelloGen no hace falta escribir a mano la etiqueta de la imagen: escribe @ en el generador de vídeo, elige la imagen y @Image1 le llega a H3 como <Picture 1>.
| Etiqueta | Para qué sirve | Ejemplo |
|---|---|---|
| <Subject N> | Un personaje, un atuendo, un objeto o un lugar tomado de una referencia | <Subject 2> is the man in <Picture 2>, short grey beard, navy wool coat. |
| <Picture N> | Una imagen que se usa tal cual como fotograma, por ejemplo el primero de un plano | <Picture 3> is the first frame of [Shot 1]. |
| (S1), (S2) | Quién habla: es una voz, no una imagen | <Subject 1> (S1) says: <d>[English] You came back.</d> |
Paso 3: Indica qué hay que conservar y no lo vuelvas a describir
En la tercera sección de un prompt de referencia de H3, retention_analysis, indicas qué hay que conservar y en qué planos aparece cada personaje. MiniMax establece valores fijos para esta sección: fully_preserved, partially_preserved, attribute_transfer y weak_reference (más o menos: conservación total, conservación parcial, transferencia de un solo atributo y referencia débil):
<Subject 1> (appears in [Shot 1], [Shot 3]): fully_preserved - her face, shoulder-length black hair and green field jacket are retained.
En español: <Subject 1> aparece en los planos 1 y 3, y se conservan por completo su cara, su pelo negro a la altura de los hombros y su chaqueta verde.
Aquí estaba también el origen de la mayoría de los cambios que tuvimos que corregir. No faltaba descripción: sobraba en el lugar equivocado. En nuestras pruebas con H3, cuando un prompt se saltaba esta sección y volvía a describir al sujeto dentro de los planos, las palabras le ganaron a la imagen en todos los casos que revisamos: a un vaso le salió un asa que no tiene, otro producto salió plateado porque el texto lo describía así ocho veces y un tercero perdió su logo. Con las personas pasa lo mismo. Así que nombra los rasgos una sola vez, aquí, y deja que la imagen se encargue de mantenerlos. En los planos, escribe lo que hace el personaje, no cómo se ve.
Tres reglas más que aprendimos en nuestras propias producciones:
- Conserva a la persona, no la foto entera. Agrega «do not reuse the reference’s background» (no reutilices el fondo de la referencia). En una de nuestras pruebas con H3, una referencia con fondo blanco apareció pegada entera en el último segundo, como un cartel.
- Nunca escribas un cambio en la persona a mitad del clip. «Her hair comes loose» (se le suelta el pelo) es una transición que el modelo no consigue resolver: salta de un estado a otro y la cara empieza a parecer la de otra persona. Si lleva el pelo suelto, que lo lleve desde el primer fotograma.
- Escribe solo lo que seguiría siendo cierto con cualquier foto. La edad, la complexión, la piel y el peinado los pone la referencia. El pelo mojado, una manga rota o barro en las botas son parte de la escena: eso sí puedes escribirlo.
Paso 4: Mantén la misma voz con un ID por hablante y una descripción fija
En una serie corta, la mitad es diálogo, y H3 habla: genera la imagen y el sonido estéreo en una sola pasada. Que el personaje correcto diga las palabras correctas con una voz reconocible depende de dos cosas.
Marcadores e identificadores. Cada frase va entre <d> y </d> con una etiqueta de idioma, y cada personaje que habla lleva un ID fijo, como (S1) o (S2), delante de su frase: <Subject 1> (S1) says: <d>[English] You said you’d call.</d> Escribir una frase como narración es la causa más común de ese balbuceo que suena a habla pero no dice nada; en nuestra guía sobre por qué H3 dice palabras sin sentido (en inglés) encontrarás la medición y siete soluciones.
La misma voz en todos los episodios. Un ID de hablante solo vale dentro de un clip. H3 no recuerda la generación anterior, así que en el episodio dos (S1) será una voz nueva, a menos que la describas igual. Escribe una descripción de voz por personaje (edad, tono, timbre, ritmo, acento), colócala antes de «says:» la primera vez que el personaje habla en un clip y pégala palabra por palabra en todos los clips:
<Subject 1>, a woman in her late twenties with a low, slightly husky voice and an unhurried pace (S1), says: <d>[English] …</d>
En español: <Subject 1>, una mujer de casi treinta años, de voz grave y algo ronca, que habla sin prisa (S1), dice: …
Si tu serie es en español, escribe el diálogo en español con su etiqueta, <d>[Spanish] Llegas cuarenta minutos tarde.</d>, y deja el resto del prompt en inglés, como indica la guía de MiniMax. El acento se pide en la descripción de la voz, por ejemplo «a Latin American Spanish voice».
En la versión de MiniMax H3 que se paga con créditos también puedes adjuntar un audio de voz de 2 a 15 segundos y declarar <Audio 1> is the voice-timbre reference for <Subject 1> (S1) (en español: <Audio 1> es la referencia de timbre de voz de <Subject 1>), tal como contempla la guía de MiniMax. H3 Unlimited solo acepta imágenes, así que ahí lo que fija la voz es la descripción escrita: no le cambies ni una palabra. Una descripción lleva a H3 hacia el mismo tipo de voz, así que espera una voz muy parecida, no un clon exacto.
Paso 5: Escribe la escena plano por plano
H3 puede hacer cortes dentro de un mismo clip. En el formato de MiniMax, el primer plano es [Shot 1], sin marca de tiempo, y cada plano siguiente empieza con el momento del corte: [Shot 2] At 00:05.000, the shot cuts to… (en el segundo 5, corte a…). Un corte debería aportar algo nuevo, como una cara, un lugar o un cambio de situación; si lo único que cambia es la distancia, mejor mueve la cámara. Estas reglas hacen que una escena entre dos personajes se entienda:
| Regla | Por qué |
|---|---|
| Un solo personaje habla en cada plano, de frente a cámara y con la boca visible | La sincronización labial funciona cuando se ve la cara. Una frase dicha con la cabeza girada o en un plano general se desfasa o acaba en la boca equivocada. |
| Primero la acción, después la frase | «She sets the cup down, then says…» (deja el vaso y luego dice…): si dice la frase mientras bebe o abraza a alguien, se le tapa la boca. |
| No más de tres personajes con acción o diálogo en un mismo plano | Es el límite que fija la lista de verificación de MiniMax para cortometrajes. |
| Las posiciones, desde el punto de vista de la cámara: «frame left» (a la izquierda del encuadre), «enters frame right» (entra por la derecha) | «To her left» (a su izquierda) se presta a confusión; el punto de vista de la cámara, no. |
| Indica las estaturas cuando dos personas comparten encuadre: con cifras o, al menos, la diferencia | «182 cm and 160 cm» o «a head taller»: si no indicas ninguna de las dos cosas, el modelo tiende a igualarlas. |
| Una frase cada 3 o 4 segundos; si no, indica qué segundos van en silencio | Una frase corta en un clip largo invita al modelo a rellenar con diálogo que nunca escribiste. |
| Las acotaciones van antes de «says:», nunca justo después de </d> | El modelo pronuncia en voz alta el texto que va justo después del marcador de cierre. |
Paso 6: Conecta cada clip con el siguiente
Cada clip de H3 dura de 4 a 15 segundos, así que un episodio son varios clips montados en un editor. Que los empalmes se noten o no se decide antes de generar:
- Termina cada clip en una situación concreta y escrita, como «ends with <Subject 1> holding the letter, the door open behind her» (termina con <Subject 1> sosteniendo la carta, con la puerta abierta detrás), y empieza el clip siguiente justo en esa situación.
- Deja por escrito los cambios que ocurren una sola vez. En nuestras producciones de varios planos, el error de continuidad más frecuente venía del propio prompt, que se contradecía, y no de que el modelo se inventara cosas: una puerta que se abría en el plano dos y otra vez en el cinco, un cinturón de seguridad que se desabrochaba dos veces. Haz una lista de lo que cambia (la puerta, el abrigo, quién se sienta dónde) y escribe cuántas veces cambia y cuándo: «the door opens exactly once, in [Shot 2], and stays open» (la puerta se abre una sola vez, en [Shot 2], y queda abierta).
- Mismo escenario, mismas palabras. Describe cada locación una sola vez, pega esa misma descripción en cada clip donde aparezca y aclara lo que no hay: «no other people, no signage» (nadie más, ningún letrero). Los fondos inventados son una causa frecuente de cambios entre planos.
- Parte del último fotograma. Exporta el último fotograma de un clip y úsalo para empezar el siguiente: H3 Unlimited tiene un modo de primer fotograma y otro, «Primer y último fotograma», pensados justo para esto. En el modo de referencia, la guía de MiniMax también permite que una imagen haga de fotograma («<Picture 3> is the first frame of [Shot 1]») mientras las demás definen a los personajes.
Cuando una frase continúa después de un corte, MiniMax pone <scenetrans> donde se interrumpe y otra vez donde se retoma en el plano siguiente, e indica que el audio continúa a través del corte. <cutoff> marca una frase que queda a medias porque el clip termina.
Una escena completa de 15 segundos para copiar
Dos referencias adjuntas: primero el retrato de ella, después el de él. En el generador de HelloGen son @Image1 y @Image2, que le llegan a H3 como <Picture 1> y <Picture 2>. Son tres planos y dos voces, y al final ella se ablanda. Cambia el reparto, el lugar y los diálogos por los tuyos, pero conserva la estructura.
La escena en pocas palabras: ella lleva cuarenta minutos esperando en un pequeño café de estación; él entra mojado por la lluvia y le dice que cancelaron el último tren y que vino caminando; ella lo observa, le acerca el vaso y le dice: «Siéntate. Todavía está caliente».
Cómo está armado el prompt: las etiquetas vinculan los dos retratos; retention_analysis fija las caras y la ropa sin repetirlas en los planos; en cada plano habla una sola persona, de frente a cámara; cada acción va antes de su frase, y cada voz se describe una sola vez, con palabras que puedes pegar tal cual en el siguiente episodio.
subject_definitions: <Subject 1> is the young woman in <Picture 1>, shoulder-length black hair, green field jacket. <Subject 2> is the man in <Picture 2>, short grey beard, navy wool coat. <Subject 3> is a small station café at night: one counter, three stools, rain on the front window.
summary: [reference generation] <Subject 1> has been waiting in <Subject 3>; <Subject 2> arrives late, and she decides to let him stay. Three shots, 15 seconds.
retention_analysis: <Subject 1> (appears in [Shot 1], [Shot 3]): fully_preserved - face, shoulder-length black hair and green field jacket are retained. <Subject 2> (appears in [Shot 2], [Shot 3]): fully_preserved - face, short grey beard and navy wool coat are retained. Do not reuse either reference’s background.
detailed_description: Live-action, naturalistic drama, cool fluorescent light inside, warm street light through the rain-streaked window. [Shot 1] A medium shot from across the counter: <Subject 1> sits on the middle stool facing the camera, both hands around a paper cup. The camera pushes in slowly. She looks up toward the door, and <Subject 1>, a woman in her late twenties with a low, slightly husky voice and an unhurried pace (S1), says: <d>[English] You’re forty minutes late.</d> [Shot 2] At 00:05.000, the shot cuts to the doorway: <Subject 2> steps in from frame right with rain on his shoulders and stops, facing the camera. <Subject 2>, a man in his fifties with a deep, quiet voice (S2), says: <d>[English] The last train was cancelled. I walked.</d> [Shot 3] At 00:10.000, an over-the-shoulder shot from behind <Subject 2>, who stands at frame right, a head taller; <Subject 1> faces the camera from her stool at frame left. She studies him, sets the cup down and slides it toward him, then <Subject 1> (S1) says: <d>[English] Sit down. It’s still warm.</d>
overall_soundscape: Rain on the window, the low hum of a drinks fridge, the door’s bell once at 00:05, wet footsteps, a paper cup sliding on laminate.
non_diegetic_music: N/A
Los errores más comunes y cómo corregirlos
Casi todos los clips fallidos de una serie se deben a unos pocos hábitos, y cada uno se corrige con una línea.
| El error | Qué pasa | La solución |
|---|---|---|
| Frases entre comillas o narradas | Un balbuceo que suena a habla o palabras equivocadas | Pon cada frase entre marcadores: (S1) says: <d>[English] …</d> |
| Referencias adjuntas pero nunca nombradas | El modelo adivina qué cara es de quién | Define un <Subject N> para cada imagen y menciónalo siempre por su etiqueta |
| Pelo y ropa descritos en cada plano | Las palabras se imponen a la imagen y los detalles cambian | Indícalos una vez en retention_analysis; en los planos, solo lo que hace el personaje |
| «4K, ultra-realistic, cinematic, masterpiece» | Nada: esas palabras no controlan ni la cámara ni la luz | Nombra la fuente de luz, el encuadre y el movimiento de cámara |
| Pronombres en vez de etiquetas | Aparece otra persona o las frases cambian de boca | Usa siempre la etiqueta |
| Pedir subtítulos o texto en pantalla en el prompt | Texto duplicado y deformado en pantalla | Agrega los subtítulos en tu editor |
| Tiempos que no suman la duración del clip | Acción atropellada o diálogo de relleno al final | Asigna un tiempo a cada plano y haz que el total coincida con la duración que elegiste (4–15 s) |
Deja que ✦ Mejorar escriba la sintaxis y repite las tomas a 0 créditos
Si las etiquetas, los marcadores y los nombres de sección te parecen puro papeleo, no te equivocas. En el generador de vídeo de HelloGen, escribe la escena como se la contarías a alguien (quién sale, qué dice, cómo termina), adjunta las imágenes de tus personajes y haz clic en ✦ Mejorar. Con MiniMax H3 seleccionado, ✦ Mejorar convierte tu idea al formato de referencia que viste arriba, siguiendo la misma guía de prompts de H3: imágenes nombradas y frases dentro de los marcadores, con su ID de hablante. Está pensado para respetar tus palabras tal cual y no añadir frases que no hayas escrito, pero revisa el resultado antes de generar. Cuesta 2 créditos, que solo se cobran si funciona.
Después, genera la escena todas las veces que haga falta. MiniMax H3 Unlimited viene incluido en Pro (desde 19,90 US$ al mes) y en Max, a 0 créditos por clip y sin límite diario: al menos 2 clips prioritarios al día en Pro y 5 en Max, y a partir de ahí, a velocidad estándar. Pro genera a 480p, y el escalador de vídeo duplica la resolución de un clip por 2 créditos cada 15 segundos; Max suma 720p HD ilimitado. Los créditos de tu plan también sirven para la versión de MiniMax H3 con créditos (2K nativo), Veo 3.1, Kling 3.0 y Seedance: vale la pena usarlos en el plano clave de cada episodio. Y si lo tuyo son los anuncios, en la guía complementaria te explicamos cómo hacer anuncios UGC de producto con H3.
Fuentes
- Skill h3-prompt-writing de MiniMax-H3 en GitHub — las seis secciones del modo de referencia, las etiquetas <Subject N> / <Picture N> / <Audio N>, los valores de retención, los ID de hablante, <scenetrans> y <cutoff>.
- Skill 3d-animation-short-generator de MiniMax-H3 en GitHub — fichas de personaje y de escenario antes del vídeo, y como máximo tres personajes importantes por plano.
- Los clips de esta página — generados en MiniMax H3 Unlimited de HelloGen a 720p, en octubre de 2026; el prompt completo de la escena del café está más arriba.
- Pruebas internas de HelloGen con H3, septiembre de 2026 — texto frente a imagen, un fondo reutilizado, texto después de </d>, frases cortas que invitan al relleno, texto en pantalla.
- Relacionados: Por qué MiniMax H3 dice palabras sin sentido y cómo solucionarlo (en inglés) y Prompts para vídeos UGC con IA en MiniMax H3.
Preguntas frecuentes
¿Cómo mantengo el mismo personaje en todos mis clips de MiniMax H3?
Adjunta la misma imagen de referencia a cada clip, defínela una vez como <Subject 1> is the woman in <Picture 1> con una frase corta que la identifique, márcala como fully_preserved en retention_analysis y menciónala por su etiqueta en cada plano. No vuelvas a describir el pelo ni la ropa en los planos, porque las palabras compiten con la imagen.
¿Cuántas imágenes de referencia acepta MiniMax H3?
Hasta nueve en el modo de referencia. Es la cifra que da MiniMax y también la que admite H3 Unlimited en HelloGen (cinco si generas a 720p). Más imágenes no siempre es mejor: envía solo las que tus planos nombran de verdad, con un personaje o un lugar por imagen.
¿Cómo consigo que mi personaje tenga la misma voz en todos los episodios?
Un ID de hablante como (S1) solo vale para un clip. Escribe una descripción de voz por personaje (edad, tono, timbre, ritmo, acento) y pégala palabra por palabra antes de «says:» en cada clip. En la versión de MiniMax H3 que se paga con créditos también puedes adjuntar un audio de voz de 2 a 15 segundos como <Audio 1>.
¿Qué diferencia hay entre <Subject N> y <Picture N> en MiniMax H3?
<Picture N> es la imagen que subiste tal cual, y se usa directamente cuando hace de fotograma, por ejemplo el primero de un plano. <Subject N> es algo que se toma de una imagen (una persona, un atuendo, un lugar) y que los planos mencionan. Los personajes son sujetos: <Subject 2> is the man in <Picture 2>.
¿Se pueden hacer escenas de más de 15 segundos con MiniMax H3?
Cada clip dura de 4 a 15 segundos. Para una escena más larga, termina cada clip en una situación concreta, empieza el siguiente desde el último fotograma del anterior, describe a los personajes y el escenario siempre con las mismas palabras y une los clips en un editor.
¿Por qué mi personaje de MiniMax H3 dice palabras sin sentido?
Casi siempre porque la frase está escrita como narración o solo entre comillas. Ponla dentro de los marcadores de diálogo de H3, con un ID de hablante y una etiqueta de idioma —(S1) says: <d>[English] the line.</d>—, y escribe las acotaciones antes de «says:», nunca justo después de </d>.