Prompts MiniMax H3 pour micro-dramas : même visage, même voix d’un clip à l’autre
 Chywe, Head of Product chez HelloGen
Épisode 1 : votre héros porte une barbe courte et une veste verte. Épisode 3 : plus de barbe, un manteau gris et une voix plus aiguë d’une octave. Si vous faites des micro-dramas, en prises de vues réelles ou en animation, vous connaissez la chanson. MiniMax H3 (Hailuo 3.0) est pourtant capable de garder ses personnages d’un clip à l’autre : il accepte jusqu’à neuf images de référence et génère une parole synchronisée avec l’image. À une condition : écrire le prompt comme le modèle le lit. Quand un personnage dérive, le prompt a presque toujours l’un de ces trois défauts : les images sont jointes mais jamais nommées, les répliques sont écrites hors des balises de dialogue de H3, ou le personnage est redécrit à chaque plan, chaque fois un peu différemment. Ce guide montre comment corriger les trois, en s’appuyant sur les règles de prompt publiées par MiniMax et sur ce que nous avons mesuré lors de nos essais sur H3. Tous les clips de cette page ont été générés sur HelloGen, et le prompt complet de la scène du café figure plus bas.
✦ Essayer MiniMax H3 Unlimited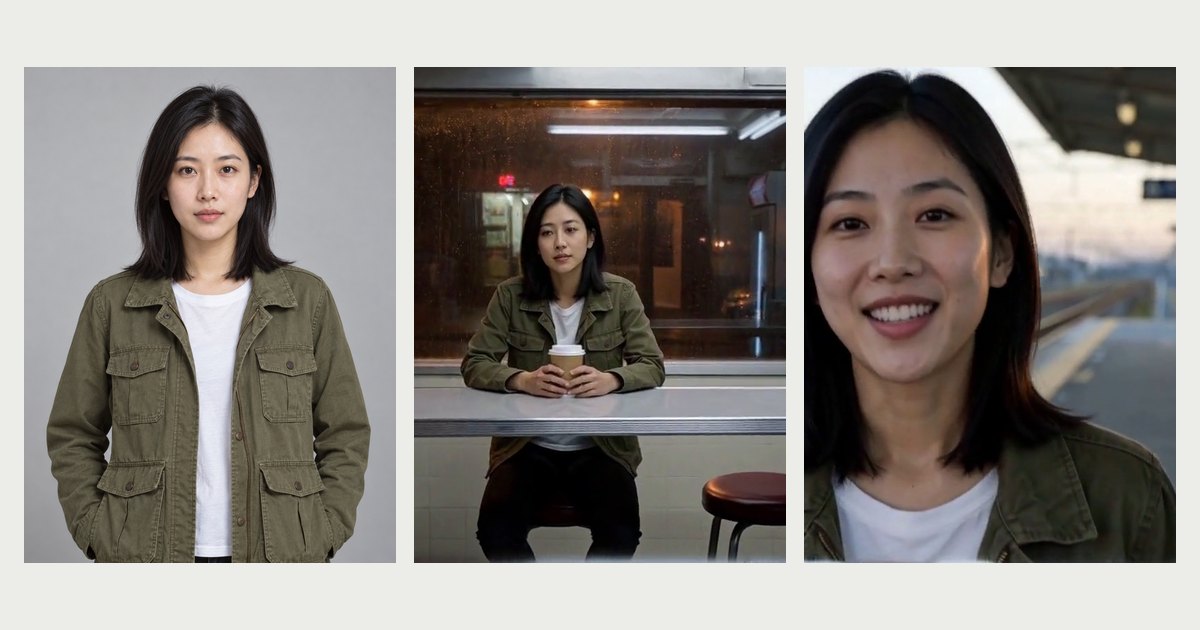
J’ai importé une image de référence : pourquoi mon personnage change-t-il encore sur MiniMax H3 ?
En bref : joignez la même image de référence à chaque clip, associez-la à une étiquette (<Subject 1> is the woman in <Picture 1>), indiquez une seule fois dans retention_analysis ce qui doit être conservé, encadrez chaque réplique de <d>…</d> avec un identifiant de locuteur, et recollez la même description de voix dans chaque clip. Les étapes ci-dessous détaillent chaque point.
Chaque clip est un rendu indépendant : H3 ne se souvient pas de l’épisode 1 quand il génère l’épisode 2. Pour savoir qui doit apparaître à l’écran, le modèle n’a que trois indices : l’image de référence que vous joignez, les étiquettes du prompt qui relient cette image à un personnage, et les mots que vous écrivez sur ce personnage. Quand un visage change, c’est que l’un des trois manque ou que deux se contredisent.
Le cas le plus courant passe facilement inaperçu : les images sont jointes, le prompt semble donc complet, mais rien n’indique au modèle quelle image correspond à quel personnage. Ensuite, les plans redécrivent la personne en toutes lettres, ce qui donne au modèle une seconde description, concurrente de l’image qui la montre déjà.
| Source | Ce qu’elle apporte | Si elle manque |
|---|---|---|
| L’image de référence | Le visage, les cheveux, la silhouette, la tenue | Le modèle invente une nouvelle personne à chaque clip |
| L’étiquette qui la relie à un personnage (<Subject 1> … <Picture 1>) | Quelle image correspond à quel personnage | Les visages sont intervertis, ou deux personnages fusionnent |
| Ce que le texte dit du personnage | Ce qu’il fait, dit et ressent dans cette scène | Si le texte redécrit son apparence, il prend le pas sur l’image et les détails changent |
Étape 1 : commencez par le casting, avec une image de référence par personnage
La méthode de court métrage publiée par MiniMax commence là, avant même la première vidéo : une fiche personnage par rôle, une fiche décor par lieu, et sur les fiches décor, le lieu seul, sans personne (3d-animation-short-generator sur GitHub). Le principe vaut pour n’importe quel modèle : une image fixe un visage mieux qu’un paragraphe.
Ce qui fait une bonne image de référence pour H3 :
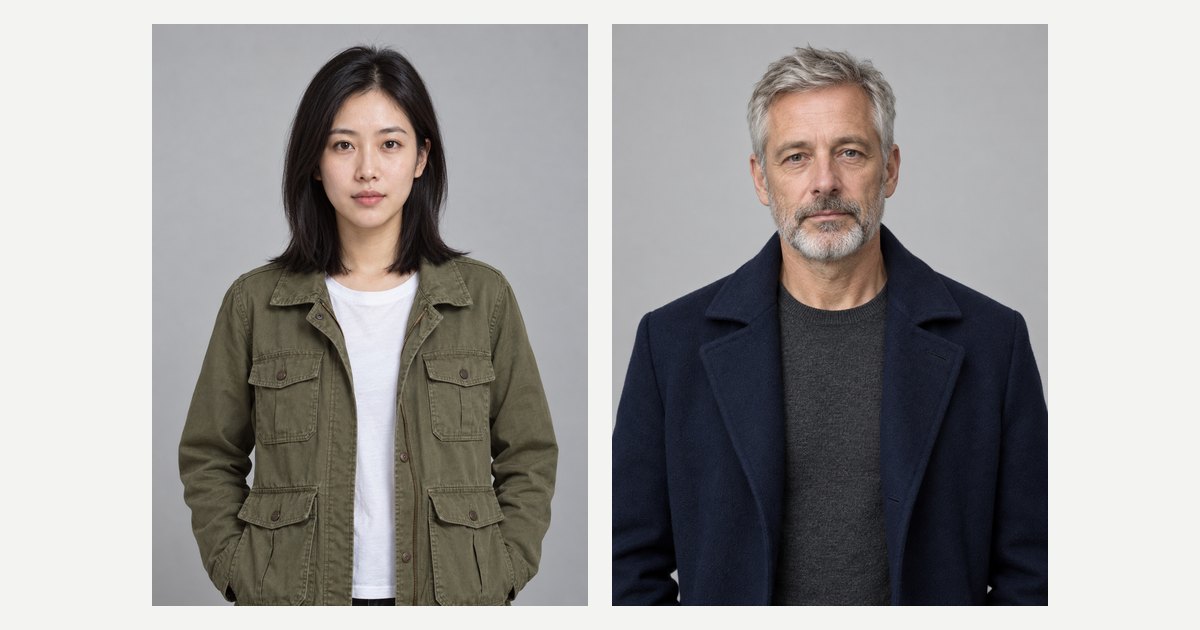
- Un seul personnage par image, en plan taille, face caméra, sur fond uni et sous un éclairage homogène, comme les deux portraits ci-dessous.
- Donnez de la place au visage. Sur H3 Unlimited chez HelloGen, chaque référence est ramenée à la taille du clip avant d’être transmise au modèle : un petit visage sur une photo en plan large, ou sur une planche de turnaround chargée, ne fait plus que quelques pixels. Le plan taille montre la tenue tout en laissant assez de place au visage.
- Mettez la tenue dans l’image, pas dans le prompt. Si votre héroïne porte la veste verte dans tous les épisodes, représentez-la avec cette veste. Un changement de costume en cours de série appelle une nouvelle image de référence, pas une phrase de plus.
- Réutilisez le même fichier pour toute la série. Une image à peine différente donne une personne à peine différente.
Vous pouvez créer votre casting avec le générateur d’images gratuit de HelloGen, enregistrer les images, puis joindre les mêmes fichiers à chaque clip.
Étape 2 : associez chaque image à un personnage avec <Subject N>
Le mode référence de H3 (« Référence Omni » dans le générateur vidéo de HelloGen) utilise ses propres étiquettes, et c’est justement ce que la plupart des prompts oublient. Le guide de MiniMax réserve <Picture N> à l’image elle-même, et <Subject N> à un élément qu’on en extrait (une personne, une tenue, un lieu) et auquel les plans peuvent ensuite faire référence (h3-prompt-writing sur GitHub). Un personnage est donc un sujet :
<Subject 1> is the young woman in <Picture 1>, with shoulder-length black hair and a green field jacket. — soit : <Subject 1> est la jeune femme de <Picture 1>, aux cheveux noirs mi-longs, en veste militaire verte.
Ensuite, dans chaque plan, écrivez « <Subject 1> », jamais « she » ni « the girl » : une étiquette n’a qu’un seul sens, dans toutes les sections du prompt. Gardez une formule d’identification courte et reprenez-la mot pour mot : dans les exemples de MiniMax, « the young man in the dark-grey hoodie » revient tel quel d’un plan à l’autre, sans le moindre synonyme. Sur HelloGen, inutile de taper les chevrons vous-même : tapez @ dans le générateur vidéo, choisissez l’image, et @Image1 est transmis à H3 sous la forme <Picture 1>.
| Étiquette | À utiliser pour | Exemple |
|---|---|---|
| <Subject N> | Un personnage, une tenue, un accessoire ou un lieu tiré d’une référence | <Subject 2> is the man in <Picture 2>, short grey beard, navy wool coat. |
| <Picture N> | Une image reprise telle quelle dans le clip, comme la première image d’un plan | <Picture 3> is the first frame of [Shot 1]. |
| (S1), (S2) | Qui parle : une voix, pas une image | <Subject 1> (S1) says: <d>[English] You came back.</d> |
Étape 3 : dites ce qui ne doit pas changer, puis cessez de le décrire
La troisième section d’un prompt de référence H3, retention_analysis, sert à indiquer ce qui doit être conservé et dans quels plans apparaît chaque personnage. MiniMax y prévoit quatre valeurs fixes : fully_preserved, partially_preserved, attribute_transfer et weak_reference (conservation totale, conservation partielle, reprise d’un seul attribut, simple référence). Par exemple :
<Subject 1> (appears in [Shot 1], [Shot 3]): fully_preserved - her face, shoulder-length black hair and green field jacket are retained. — en clair : <Subject 1>, présente dans les plans 1 et 3, est conservée à l’identique : visage, cheveux noirs mi-longs et veste militaire verte.
La plupart des dérives que nous avons dû corriger venaient d’ailleurs de là : la description existait, mais au mauvais endroit. Lors de nos essais sur H3, quand un prompt sautait cette section et redécrivait le sujet dans les plans, les mots ont pris le dessus sur l’image à chaque vérification : une tasse s’est vu ajouter une anse qu’elle n’a pas, un autre produit est ressorti argenté parce que le texte répétait « silver » huit fois, un troisième a perdu son logo. Les personnages dérivent exactement de la même manière. Nommez donc les traits une seule fois, ici, et laissez l’image faire le reste. Dans les plans, décrivez ce que fait le personnage, pas son apparence.
Trois autres règles tirées de nos propres productions :
- Gardez la personne, pas le reste de l’image. Ajoutez « do not reuse the reference’s background » (ne pas reprendre le fond de la référence). Lors d’un de nos essais sur H3, une référence sur fond blanc s’est retrouvée collée telle quelle dans la dernière seconde du clip, comme un carton.
- Pas de transformation du personnage en cours de clip. « Her hair comes loose » (ses cheveux se dénouent) est une transition que le modèle ne sait pas représenter : l’image hésite entre les deux états, et le visage finit par ressembler à quelqu’un d’autre. Si elle doit avoir les cheveux détachés, qu’elle les ait dès la première image.
- N’écrivez que ce qui resterait vrai quelle que soit la photo jointe. L’âge, la morphologie, le teint et la coiffure relèvent de la référence. Des cheveux mouillés, une manche déchirée, de la boue sur les bottes relèvent de la scène : ces détails-là, vous pouvez les écrire.
Étape 4 : une voix stable, avec un identifiant par locuteur et toujours la même description
Un micro-drama, c’est pour moitié du dialogue, et H3 parle : l’image et le son stéréo sont générés en une seule passe. Deux éléments déterminent si le bon personnage dit les bons mots, avec une voix que l’on reconnaît.
Balises et identifiants. Chaque réplique se place entre <d> et </d>, avec une balise de langue, et chaque personnage qui parle reçoit un identifiant fixe, (S1), (S2), placé avant sa réplique : <Subject 1> (S1) says: <d>[English] You said you’d call.</d> Une réplique noyée dans la prose est la cause la plus fréquente de ces sons qui ressemblent à de la parole sans en être ; notre article sur le charabia de H3 détaille ce que nous avons mesuré et sept façons d’y remédier.
La même voix d’un épisode à l’autre. Un identifiant de locuteur ne vaut que le temps d’un clip. H3 ne garde aucun souvenir du rendu précédent : le (S1) de l’épisode 2 aura une nouvelle voix, sauf si vous la décrivez de la même façon. Rédigez une description de voix par personnage (âge, hauteur, timbre, débit, accent), placez-la avant « says: » à sa première réplique dans le clip, et recollez-la mot pour mot dans chaque clip :
<Subject 1>, a woman in her late twenties with a low, slightly husky voice and an unhurried pace (S1), says: <d>[English] …</d> — c’est-à-dire une femme qui approche de la trentaine, à la voix grave, un peu voilée, et au débit posé.
Avec la version de MiniMax H3 facturée en crédits, vous pouvez aussi joindre un extrait vocal de 2 à 15 secondes et déclarer <Audio 1> is the voice-timbre reference for <Subject 1> (S1), comme le prévoit le guide de MiniMax. H3 Unlimited n’accepte que des images : le seul repère est alors la description écrite, d’où l’importance de ne jamais la modifier. Une description oriente H3 vers le même type de voix ; attendez-vous à une voix proche, pas à la copie conforme d’un enregistrement.
Étape 5 : écrivez la scène plan par plan
H3 sait enchaîner plusieurs plans dans un même clip. Dans le format de MiniMax, le premier plan s’écrit [Shot 1], sans minutage, et chaque plan suivant commence par le moment de la coupe : [Shot 2] At 00:05.000, the shot cuts to… Une coupe doit apporter quelque chose de nouveau (un visage, un lieu, un changement d’état) ; si seule la valeur de plan change, faites plutôt bouger la caméra. Pour qu’une scène à deux personnages reste lisible :
| Règle | Pourquoi |
|---|---|
| Un seul personnage parle par plan, face caméra, la bouche visible | La synchro labiale a besoin d’un visage visible. Dite tête tournée ou en plan large, une réplique se décale, ou se retrouve dans la mauvaise bouche. |
| L’action d’abord, la réplique ensuite | « She sets the cup down, then says… » (elle pose la tasse, puis dit…) : dite en buvant ou en enlaçant quelqu’un, une réplique se fait bouche cachée. |
| Pas plus de trois personnages qui agissent ou parlent dans le même plan | C’est la limite fixée par la checklist de court métrage de MiniMax. |
| Des positions données du point de vue de la caméra : « frame left » (à gauche du cadre), « enters frame right » (entre dans le champ par la droite) | « To her left » (à sa gauche) prête à confusion ; le point de vue de la caméra, jamais. |
| Indiquer les tailles quand deux personnes partagent le cadre : en chiffres, ou au moins l’écart | « 182 cm and 160 cm » ou « a head taller » : sans aucune des deux indications, le modèle a tendance à leur donner la même taille. |
| Une réplique toutes les 3 à 4 secondes, ou des secondes muettes indiquées comme telles | Une réplique courte dans un clip long pousse le modèle à meubler avec des paroles que vous n’avez jamais écrites. |
| Les indications de jeu avant « says: », jamais juste après </d> | Tout texte placé juste après la balise fermante est prononcé à voix haute. |
Étape 6 : assurez les raccords d’un clip à l’autre
H3 génère des clips de 4 à 15 secondes : un épisode se compose donc de plusieurs clips assemblés au montage. Que les raccords se voient ou non, tout se joue avant le rendu :
- Décrivez la situation sur laquelle chaque clip se termine, par exemple « ends with <Subject 1> holding the letter, the door open behind her » (<Subject 1> tient la lettre, la porte ouverte derrière elle), et faites démarrer le clip suivant exactement là.
- Verrouillez les changements qui ne doivent arriver qu’une fois. Dans nos productions multiplans, le faux raccord le plus fréquent ne venait pas du modèle : c’est le prompt qui se contredisait. Une porte qui s’ouvre au plan 2, puis à nouveau au plan 5 ; une ceinture de sécurité détachée deux fois. Listez ce qui change (la porte, le manteau, qui est assis où) et précisez combien de fois et à quel moment : « the door opens exactly once, in [Shot 2], and stays open » (la porte s’ouvre une seule fois, au plan 2, et reste ouverte).
- Même décor, mêmes mots. Décrivez chaque lieu une fois, recollez cette description telle quelle dans chaque clip qui s’y déroule, et précisez ce qui ne s’y trouve pas : « no other people, no signage » (personne d’autre, aucune enseigne). Un arrière-plan inventé par le modèle est une cause fréquente de dérive d’un plan à l’autre.
- Passez le relais avec la dernière image. Exportez la dernière image d’un clip et faites partir le suivant de celle-ci : H3 Unlimited accepte justement une première image, ou une première et une dernière image, pour ce genre d’enchaînement. En mode référence, le guide de MiniMax prévoit aussi qu’une image serve de point de départ à un plan (« <Picture 3> is the first frame of [Shot 1] »), pendant que les autres définissent les personnages.
Pour une réplique à cheval sur une coupe, MiniMax place <scenetrans> là où la réplique s’interrompt, puis à nouveau là où elle reprend dans le plan suivant, en précisant que le son se poursuit par-dessus la coupe ; <cutoff> signale une parole interrompue par la fin du clip.
Une scène complète de 15 secondes à copier
Deux références sont jointes, dans cet ordre : le portrait de la femme, puis celui de l’homme. Dans le générateur vidéo de HelloGen, ce sont @Image1 et @Image2, transmises à H3 sous la forme <Picture 1> et <Picture 2>. Trois plans, deux voix, un revirement. Remplacez le casting, le lieu et les répliques par les vôtres, mais gardez la structure.
Racontée en français, la scène donne ceci : un petit café de gare, la nuit. Elle l’attend depuis quarante minutes. Il entre, les épaules mouillées de pluie : le dernier train a été annulé, il est venu à pied. Elle le regarde longuement, pose son gobelet et le fait glisser vers lui : « Assieds-toi. Il est encore chaud. »
Ce qu’il faut remarquer dans le prompt ci-dessous : les étiquettes rattachent chaque portrait à son personnage, retention_analysis fixe les visages et les tenues sans qu’on les répète dans les plans, chaque plan n’a qu’un locuteur face caméra, chaque action précède sa réplique, et chaque voix n’est décrite qu’une fois, avec des mots que vous pourrez recoller tels quels dans l’épisode suivant. Le prompt est rédigé en anglais, comme le recommande le guide de MiniMax ; pour des répliques en français, laissez le reste en anglais et ne changez que la réplique et sa balise de langue : <d>[French] Assieds-toi. Il est encore chaud.</d>
subject_definitions: <Subject 1> is the young woman in <Picture 1>, shoulder-length black hair, green field jacket. <Subject 2> is the man in <Picture 2>, short grey beard, navy wool coat. <Subject 3> is a small station café at night: one counter, three stools, rain on the front window.
summary: [reference generation] <Subject 1> has been waiting in <Subject 3>; <Subject 2> arrives late, and she decides to let him stay. Three shots, 15 seconds.
retention_analysis: <Subject 1> (appears in [Shot 1], [Shot 3]): fully_preserved - face, shoulder-length black hair and green field jacket are retained. <Subject 2> (appears in [Shot 2], [Shot 3]): fully_preserved - face, short grey beard and navy wool coat are retained. Do not reuse either reference’s background.
detailed_description: Live-action, naturalistic drama, cool fluorescent light inside, warm street light through the rain-streaked window. [Shot 1] A medium shot from across the counter: <Subject 1> sits on the middle stool facing the camera, both hands around a paper cup. The camera pushes in slowly. She looks up toward the door, and <Subject 1>, a woman in her late twenties with a low, slightly husky voice and an unhurried pace (S1), says: <d>[English] You’re forty minutes late.</d> [Shot 2] At 00:05.000, the shot cuts to the doorway: <Subject 2> steps in from frame right with rain on his shoulders and stops, facing the camera. <Subject 2>, a man in his fifties with a deep, quiet voice (S2), says: <d>[English] The last train was cancelled. I walked.</d> [Shot 3] At 00:10.000, an over-the-shoulder shot from behind <Subject 2>, who stands at frame right, a head taller; <Subject 1> faces the camera from her stool at frame left. She studies him, sets the cup down and slides it toward him, then <Subject 1> (S1) says: <d>[English] Sit down. It’s still warm.</d>
overall_soundscape: Rain on the window, the low hum of a drinks fridge, the door’s bell once at 00:05, wet footsteps, a paper cup sliding on laminate.
non_diegetic_music: N/A
Les erreurs les plus fréquentes et comment les corriger
Quelques habitudes suffisent à gâcher la plupart des clips narratifs, et chacune se corrige en une ligne.
| Erreur | Résultat | Correctif |
|---|---|---|
| Des répliques entre guillemets ou noyées dans la prose | Des sons qui imitent la parole, des mots qui ne sont pas les bons | Encadrez chaque réplique : (S1) says: <d>[English] …</d> |
| Des références jointes mais jamais nommées | Le modèle devine à qui appartient chaque visage | Définissez un <Subject N> par image, puis désignez-le toujours par cette étiquette |
| La coiffure et la tenue décrites à chaque plan | Les mots prennent le pas sur l’image, et les détails changent | Indiquez-les une fois dans retention_analysis ; dans les plans, décrivez seulement l’action |
| « 4K, ultra-realistic, cinematic, masterpiece » | Aucun effet utile : ces mots ne dirigent ni la caméra ni la lumière | Nommez la source de lumière, le cadrage et le mouvement de caméra |
| Des pronoms au lieu des étiquettes | Une deuxième personne apparaît, ou les répliques passent d’une bouche à l’autre | Écrivez l’étiquette à chaque fois |
| Des sous-titres ou du texte à l’écran demandés dans le prompt | Du texte dédoublé et illisible à l’écran | Ajoutez les sous-titres au montage |
| Des plans dont la durée totale ne correspond pas à celle du clip | Une action précipitée, ou des paroles de remplissage à la fin | Minutez chaque plan : le total doit tomber pile sur la durée choisie (4 à 15 s) |
Laissez ✦ Améliorer écrire la syntaxe, puis itérez à 0 crédit
Si toutes ces étiquettes, ces balises et ces noms de section vous donnent l’impression de tenir une comptabilité, c’est normal : c’en est une. Dans le générateur vidéo de HelloGen, écrivez la scène comme vous la raconteriez à quelqu’un (qui est là, ce qu’ils se disent, comment ça se termine), joignez vos images de personnages et cliquez sur ✦ Améliorer. Pour MiniMax H3, l’outil réécrit votre idée au format référence décrit plus haut, en suivant le même guide de prompts H3 : images nommées, répliques balisées avec leurs identifiants de locuteur. Il est conçu pour conserver vos mots tels quels et ne pas ajouter de répliques à votre place ; relisez tout de même le résultat avant de lancer la génération. L’amélioration coûte 2 crédits, débités seulement si elle aboutit.
Générez ensuite la scène autant de fois que nécessaire. MiniMax H3 Unlimited est inclus dans les offres Pro (à partir de 19,90 $US par mois) et Max, à 0 crédit par clip et sans plafond quotidien : au moins 2 clips prioritaires par jour avec Pro, 5 avec Max, puis vitesse standard au-delà. Pro génère en 480p, et l’upscaler vidéo double la résolution d’un clip pour 2 crédits par tranche de 15 secondes ; Max ajoute la HD 720p illimitée. Les crédits inclus dans votre offre donnent aussi accès à MiniMax H3 en 2K natif, à Veo 3.1, à Kling 3.0 et à Seedance : de quoi soigner le plan phare d’un épisode. Pour des scènes publicitaires, consultez notre guide des publicités produit UGC avec H3 (en anglais).
Sources
- Le skill h3-prompt-writing de MiniMax-H3 sur GitHub — les six sections du mode référence, les étiquettes <Subject N> / <Picture N> / <Audio N>, les valeurs de conservation, les identifiants de locuteur, <scenetrans> et <cutoff>.
- Le skill 3d-animation-short-generator de MiniMax-H3 sur GitHub — fiches personnages et fiches décors avant toute vidéo, au plus trois personnages importants par plan.
- Les clips de cette page — générés en 720p avec MiniMax H3 Unlimited sur HelloGen, en octobre 2026 ; le prompt complet de la scène du café figure plus haut.
- Les essais de HelloGen sur H3, septembre 2026 — les mots face à l’image, un fond de référence réutilisé, du texte après </d>, des répliques courtes qui poussent le modèle à meubler, du texte à l’écran.
- À lire aussi : MiniMax H3 parle en charabia ? D’où ça vient et comment le corriger et Prompts de vidéos UGC pour MiniMax H3 (en anglais).
Questions fréquentes
Comment garder le même personnage d’un clip MiniMax H3 à l’autre ?
Joignez la même image de référence à chaque clip et associez-la une seule fois à son personnage, avec une courte formule d’identification (<Subject 1> is the woman in <Picture 1>…). Marquez ce personnage fully_preserved dans retention_analysis, puis désignez-le par son étiquette dans chaque plan. Ne redécrivez ni la coiffure ni les vêtements dans les plans : les mots entreraient en concurrence avec l’image.
Combien d’images de référence MiniMax H3 accepte-t-il ?
Jusqu’à neuf en mode référence : c’est le chiffre donné par MiniMax, et c’est aussi la limite de H3 Unlimited sur HelloGen (cinq si vous générez en 720p). Plus d’images ne garantit pas un meilleur résultat : n’envoyez que celles que vos plans citent réellement, avec un personnage ou un lieu par image.
Comment garder la même voix à un personnage d’un épisode à l’autre ?
Un identifiant de locuteur comme (S1) ne vaut que le temps d’un clip. Rédigez une description de voix par personnage (âge, hauteur, timbre, débit, accent) et recollez-la mot pour mot avant « says: » dans chaque clip. Avec la version de MiniMax H3 facturée en crédits, vous pouvez aussi joindre un extrait vocal de 2 à 15 secondes comme <Audio 1>.
Quelle est la différence entre <Subject N> et <Picture N> dans MiniMax H3 ?
<Picture N> désigne l’image importée elle-même, reprise telle quelle dans le clip, par exemple comme première image d’un plan. <Subject N> désigne un élément tiré d’une image (une personne, une tenue, un lieu) auquel les plans font référence. Les personnages sont donc des sujets : <Subject 2> is the man in <Picture 2>.
MiniMax H3 peut-il générer une scène de plus de 15 secondes ?
Un clip dure de 4 à 15 secondes. Pour une scène plus longue, décrivez la situation sur laquelle chaque clip se termine, démarrez le clip suivant à partir de la dernière image du précédent, décrivez les personnages et le décor avec exactement les mêmes mots, puis assemblez les clips au montage.
Pourquoi mon personnage MiniMax H3 parle-t-il en charabia ?
Le plus souvent, parce que la réplique est noyée dans la prose ou simplement mise entre guillemets. Placez-la dans les balises de dialogue de H3, avec un identifiant de locuteur et une balise de langue — (S1) says: <d>[English] the line.</d> — et gardez les indications de jeu avant « says: », jamais juste après </d>.