MiniMax H3 短剧提示词怎么写:角色不换脸,声音不变调
 Chywe,HelloGen 产品负责人
第一集,主角留着短胡子,穿一件绿夹克。到了第三集,胡子没了,夹克换成了灰大衣,嗓音还高了八度。用 AI 做过短剧的人,不管做的是漫剧还是真人短剧,多半都被这种事折腾过。其实 MiniMax H3(海螺 3.0)能让同一个角色在一条接一条的视频里保持原样:它最多支持 9 张参考图,人声和画面一起生成,口型对得上。前提是提示词要按它读得懂的方式写。角色一走样,提示词里几乎总有下面三个漏洞之一:图附上了,却没告诉模型哪张是谁;台词没放进 H3 的对白标记;每个镜头都把角色重新描述一遍,而且每次说法都不太一样。本文依据 MiniMax 官方的提示词规则和我们自己的 H3 测试,把这三个漏洞逐个补上。文中的视频都是在 HelloGen 上生成的,咖啡馆那场戏的完整提示词就附在下文。
✦ 试试 MiniMax H3 Unlimited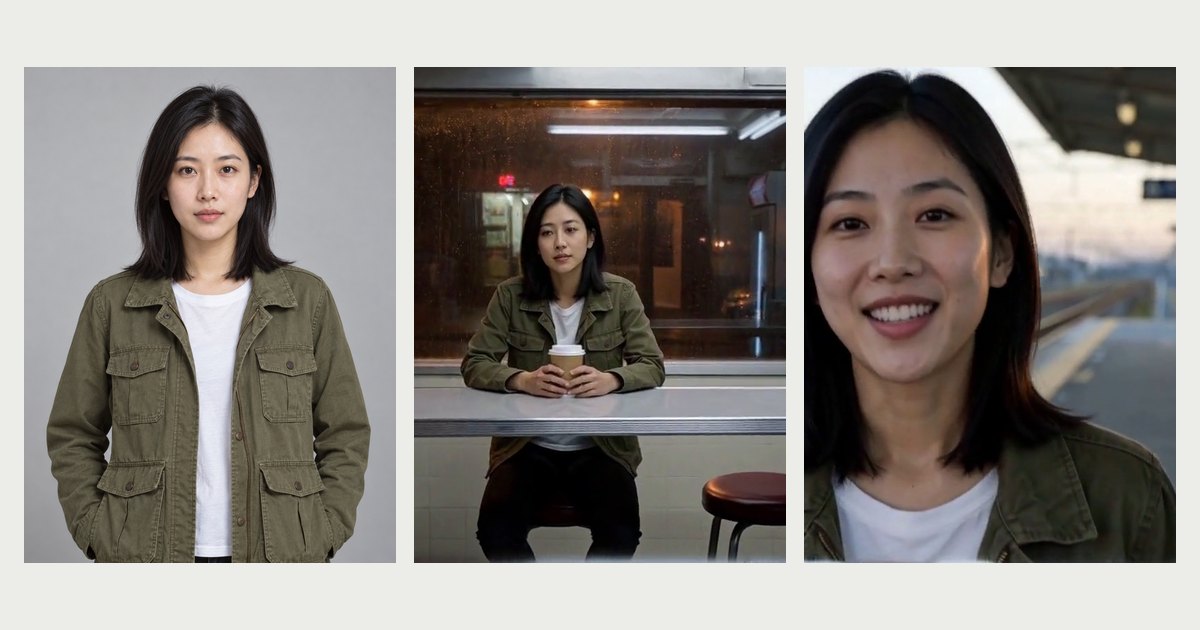
明明上传了参考图,角色为什么还会换脸?
简单说:每条视频都附同一张参考图,用标签把它绑到角色上(<Subject 1> is the woman in <Picture 1>),在 retention_analysis 里写一次哪些不能变,每句台词都用 <d>…</d> 包起来并加上说话人编号,再把同一段声音描述贴进每一条视频。下面分步讲怎么做。
每条视频都是单独生成的。H3 生成第二集时,并不记得第一集里的人长什么样。所以在一条视频里,模型判断「这个人是谁」只靠三样东西:你附的参考图、提示词里把图和角色绑在一起的标签,以及你描写这个角色的文字。脸一走样,要么是三样里缺了一样,要么是其中两样互相矛盾。
最常见、也最容易被忽略的情况是:图附上了,提示词看起来也写完了,却没有一句话告诉模型哪张图是谁。然后镜头里又用文字把这个人描述一遍。参考图里明明已经有这个人,你又给了模型第二份描述,两份还对不上。
| 靠什么认人 | 管的是什么 | 缺了会怎样 |
|---|---|---|
| 参考图 | 脸、发型、身材、衣服 | 每条视频都换了一个人 |
| 把图绑到角色上的标签(<Subject 1> … <Picture 1>) | 哪张图是哪个角色 | 两个人的脸对调,或者两个角色混成一个人 |
| 描写角色的文字 | 角色在这场戏里做什么、说什么、什么情绪 | 文字一旦又去描述长相,就会盖过参考图,细节跟着变 |
第一步:先定妆,每个角色一张参考图
MiniMax 官方的短片工作流也是先做这一步再出视频:每个人物一张角色卡,每个地点一张场景卡,场景卡里只有场景,不放人(GitHub 上的 3d-animation-short-generator)。这个道理放到任何模型上都成立:要锁住一张脸,一张图比一段文字靠谱。
角色参考图这样做,H3 用起来才顺手:
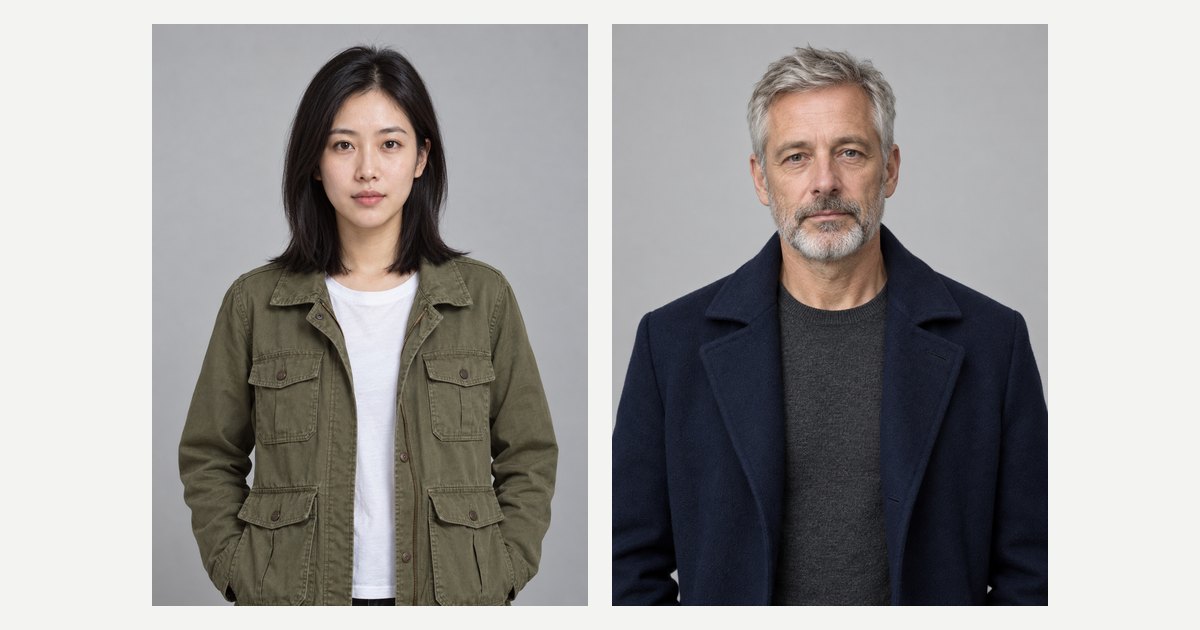
- 一张图只放一个角色:腰部以上,正对镜头,纯色背景,光线均匀,就像下面这两张。
- 脸要大。在 HelloGen 的 H3 Unlimited 上,每张参考图都会先缩放到视频画面的尺寸,再交给模型。所以广角照片里的一张小脸,或者挤满整张图的三视图,到了模型那里只剩几个像素。腰部以上的构图既能看清衣服,脸也足够大。
- 衣服画在图里,别写在提示词里。女主每一集都穿那件绿夹克,就让她在参考图里穿着绿夹克。剧情里要换装,就换一张参考图,别靠加一句话。
- 整部剧都用同一个图片文件。图有一点不同,人就会有一点不同。
这些角色图可以用 HelloGen 的免费图片生成器来画,画好后保存下来,之后每条视频都附上同样的文件。
第二步:用 <Subject N> 告诉模型哪张图是谁
H3 的参考模式(视频生成器里叫「全能参考」)有自己的一套标签,而给图点名是最容易漏掉的一步。按 MiniMax 官方指南的写法,<Picture N> 指图片本身;<Subject N> 指从图里取出的某个对象,可以是一个人、一套衣服或一个地方,后面的镜头都用这个标签来指代它(GitHub 上的 h3-prompt-writing)。角色就是一个 Subject:
<Subject 1> is the young woman in <Picture 1>, with shoulder-length black hair and a green field jacket.
意思是:<Subject 1> 就是 <Picture 1> 里那个年轻女人,齐肩黑发,穿绿色工装夹克。
从这句开始,每个镜头都写「<Subject 1>」,不要写「she」「the girl」这类代称。一个标签只对应一个人,在提示词的每一节里都是如此。用来认人的那句描述要短,每次出现都一字不差。MiniMax 自己的示例就是这样:每个镜头都写「the young man in the dark-grey hoodie」,从不换说法。在 HelloGen 上,图片标签的尖括号不用手敲:在视频生成器里输入 @ 选中图片,发给 H3 时 @Image1 就会换成 <Picture 1>。
| 标签 | 用来指什么 | 例子 |
|---|---|---|
| <Subject N> | 从参考图里取出的角色、服装、道具或地点 | <Subject 2> is the man in <Picture 2>, short grey beard, navy wool coat. |
| <Picture N> | 直接当画面用的图片,比如某个镜头的首帧 | <Picture 3> is the first frame of [Shot 1]. |
| (S1)、(S2) | 标明谁在说话;对应的是声音,不是图片 | <Subject 1> (S1) says: <d>[English] You came back.</d> |
第三步:写清哪些不能变,之后别再重复描述
H3 参考模式的提示词分成几节,第三节叫 retention_analysis,用来写明哪些东西必须保留、每个角色出现在哪几个镜头。MiniMax 给这一节规定了四个固定取值:fully_preserved、partially_preserved、attribute_transfer、weak_reference(大致是完全保留、部分保留、只沿用某个属性、只作弱参考):
<Subject 1> (appears in [Shot 1], [Shot 3]): fully_preserved - her face, shoulder-length black hair and green field jacket are retained.
意思是:<Subject 1> 出现在第 1 和第 3 个镜头,完全保留,她的脸、齐肩黑发和绿色工装夹克都不变。
我们调提示词时遇到的走样,大多也出在这一节:问题往往不在描述太少,而在描述放错了地方。在我们自己的 H3 测试里,只要提示词跳过这一节,又在镜头里把主体重新描述一遍,我们查过的每一次,都是文字压过了参考图:一只杯子长出了它本来没有的把手;另一件产品因为文字里写了八遍「银色」,出来就成了银色;第三件产品上的 logo 直接没了。人物也一样会跑偏。所以长相特征只在这一节写一次,其余交给参考图。镜头里只写角色在做什么,不写角色长什么样。
下面三条是我们自己做片子时总结的:
- 只要图里的人,不要整张图。加一句「do not reuse the reference’s background」(不要沿用参考图的背景)。在一次 H3 测试里,一张白底参考图在最后一秒被整张贴进了画面,像立了块牌子。
- 别让人物在一条视频中途变样。像「Her hair comes loose」(头发散开)这样的变化过程,模型画不出来:画面会在两种状态之间来回闪,脸也越来越不像本人。要散着头发,就让她从第一帧起就散着。
- 文字只写剧情里的状态,不写人本来的样子。年龄、身材、肤色、发型交给参考图;头发湿了、袖子破了、靴子上沾了泥,这些属于剧情,可以写。
第四步:想让每集声音一样,就给每人一个编号、用同一段描述
短剧有一半是台词戏,而 H3 本身就能出声:画面和立体声是一次生成的。要让该说话的角色用你认得出的声音把台词说对,关键在两件事。
对白标记和说话人编号。每句台词都放在 <d> 和 </d> 之间,并加上语言标签;每个说话的角色有一个固定编号,比如 (S1)、(S2),写在台词前面:<Subject 1> (S1) says: <d>[English] You said you’d call.</d> 台词要是写成叙述,最容易出来一段听着像在说话、却听不出字的声音。MiniMax H3 人物乱说话怎么办一文里有我们的实测和 7 种改法。
每一集都用同一个声音。说话人编号只在当前这条视频里有效。H3 不记得上一条,所以除非你用同样的话再描述一遍,第二集里的 (S1) 就是一个新声音。给每个角色写一段声音描述,写明年龄、音高、音色、语速和口音。角色在一条视频里第一次开口时,把这段描述放在「says:」前面,并且一字不差地贴进每一条视频:
<Subject 1>, a woman in her late twenties with a low, slightly husky voice and an unhurried pace (S1), says: <d>[English] …</d>
意思是:<Subject 1>,一位二十八九岁的女性,嗓音偏低、略带沙哑,说话不紧不慢,(S1) 说:……
用 MiniMax H3 积分版时,还可以附一段 2–15 秒的声音素材,并写上 <Audio 1> is the voice-timbre reference for <Subject 1> (S1)(把 <Audio 1> 作为 <Subject 1> 的音色参考),MiniMax 的指南支持这种写法。H3 Unlimited 只接受图片,声音完全由这段文字描述决定,所以一个字都别改。声音描述能让 H3 每次都往同一类声音上靠,效果是很接近,但不是复刻原声。
第五步:把一场戏拆成镜头来写
H3 能在一条视频里切镜头。按 MiniMax 的格式,第一个镜头只写 [Shot 1],不写时间;之后每个镜头开头都写上切换的时间点:[Shot 2] At 00:05.000, the shot cuts to… 每次切镜都要带来新东西:一张新面孔、一个新地点,或者一种新状态。如果只是景别变了,就别切,用运镜代替。要让两个人的对手戏看得明白,靠下面这几条:
| 规则 | 为什么 |
|---|---|
| 一个镜头只让一个人说话:正对镜头,嘴要露出来 | 看得见脸,口型才对得上。人侧过头或在远景里说台词,口型会飘,台词还可能安到别人头上。 |
| 先做动作,再说台词 | 写成「She sets the cup down, then says…」(她放下杯子,然后说……)。边喝边说、边拥抱边说,嘴会被挡住。 |
| 一个镜头里有动作或台词的角色,最多三个 | MiniMax 官方的短片检查清单定的就是这个上限。 |
| 位置按镜头视角来写:「frame left」(画面左侧)、「enters frame right」(从画面右侧入画) | 「To her left」(在她左边)分不清是哪一边;按镜头视角写就不会有歧义。 |
| 两个人同框时,要写清身高:最好写数字,至少写出高矮关系 | 比如「182 cm and 160 cm」或「a head taller」(高出一个头)。两样都不写,模型往往会把两个人画成差不多高。 |
| 每 3–4 秒一句台词,或者写明哪几秒不说话 | 长视频里只写一句短台词,模型会自己补出你没写的话。 |
| 表演说明写在「says:」前面,不要紧跟在 </d> 后面 | 紧跟在结束标记后面的文字,会被当成台词念出来。 |
第六步:让上一条和下一条接得上
H3 每次生成 4 到 15 秒,一集戏要用好几条视频在剪辑软件里拼起来。接缝处会不会穿帮,生成之前就已经定了:
- 每条视频都结束在一个写明的状态上,比如「ends with <Subject 1> holding the letter, the door open behind her」(结尾时 <Subject 1> 拿着那封信,身后的门开着),下一条就从这个状态原样接着开始。
- 只发生一次的变化,要写死。我们自己做多镜头片子时,最常见的穿帮来自提示词前后矛盾,而不是模型乱编:门在第二个镜头开了一次,到第五个镜头又开了一次;安全带解了两回。把会变的东西列出来,比如门、外套、谁坐在哪,写清楚变几次、什么时候变:「the door opens exactly once, in [Shot 2], and stays open」(门只在 [Shot 2] 打开一次,之后一直开着)。
- 同一个场景,用同一段描述。每个地点只写一段描述,凡是用到这个地点的视频都原样粘贴,并写明哪些东西不出现:「no other people, no signage」(没有其他人,没有招牌)。镜头之间接不上,模型自己补出来的背景是常见原因。
- 用尾帧接力。把上一条的最后一帧导出来,作为下一条的开头。H3 Unlimited 的首帧和首尾帧模式就是为此准备的。在参考模式下,MiniMax 的指南也允许把一张图直接当画面用(「<Picture 3> is the first frame of [Shot 1]」),其余几张照样用来定角色。
如果一句台词跨过了切镜点,MiniMax 的写法是在台词断开的地方和下一个镜头接上的地方各加一个 <scenetrans>,并写明声音延续到下一个镜头;被视频结尾截断的话,则用 <cutoff> 标出。
直接复制:一场完整的 15 秒戏
附两张参考图:先附女人的,再附男人的。在 HelloGen 的视频生成器里,它们是 @Image1 和 @Image2,发给 H3 时就成了 <Picture 1> 和 <Picture 2>。整场戏三个镜头、两个人说话,讲的是她最后心软的那一刻。角色、场景和台词都可以换成你自己的,结构别动。
下面这段提示词是这样搭起来的:标签把两张参考图分别绑到两个人身上;retention_analysis 锁住脸和外套,镜头里就不必再写;每个镜头只有一个人说话,而且正对镜头;动作都放在台词之前;每个声音只描述一次,这段话下一集可以原样粘贴。
这场戏用中文讲一遍:深夜的车站咖啡馆,她已经等了四十分钟;他淋着雨进门,说末班车取消了,他是走过来的;她打量了他一会儿,把杯子推过去:「坐吧,还热着。」
subject_definitions: <Subject 1> is the young woman in <Picture 1>, shoulder-length black hair, green field jacket. <Subject 2> is the man in <Picture 2>, short grey beard, navy wool coat. <Subject 3> is a small station café at night: one counter, three stools, rain on the front window.
summary: [reference generation] <Subject 1> has been waiting in <Subject 3>; <Subject 2> arrives late, and she decides to let him stay. Three shots, 15 seconds.
retention_analysis: <Subject 1> (appears in [Shot 1], [Shot 3]): fully_preserved - face, shoulder-length black hair and green field jacket are retained. <Subject 2> (appears in [Shot 2], [Shot 3]): fully_preserved - face, short grey beard and navy wool coat are retained. Do not reuse either reference’s background.
detailed_description: Live-action, naturalistic drama, cool fluorescent light inside, warm street light through the rain-streaked window. [Shot 1] A medium shot from across the counter: <Subject 1> sits on the middle stool facing the camera, both hands around a paper cup. The camera pushes in slowly. She looks up toward the door, and <Subject 1>, a woman in her late twenties with a low, slightly husky voice and an unhurried pace (S1), says: <d>[English] You’re forty minutes late.</d> [Shot 2] At 00:05.000, the shot cuts to the doorway: <Subject 2> steps in from frame right with rain on his shoulders and stops, facing the camera. <Subject 2>, a man in his fifties with a deep, quiet voice (S2), says: <d>[English] The last train was cancelled. I walked.</d> [Shot 3] At 00:10.000, an over-the-shoulder shot from behind <Subject 2>, who stands at frame right, a head taller; <Subject 1> faces the camera from her stool at frame left. She studies him, sets the cup down and slides it toward him, then <Subject 1> (S1) says: <d>[English] Sit down. It’s still warm.</d>
overall_soundscape: Rain on the window, the low hum of a drinks fridge, the door’s bell once at 00:05, wet footsteps, a paper cup sliding on laminate.
non_diegetic_music: N/A
几个常见错误和改法
剧情视频翻车,多半是下面这几种写法造成的,每一种都只需改一句。
| 常见写法 | 结果 | 改法 |
|---|---|---|
| 台词用引号或叙述来写 | 出来一段像说话的杂音,或者词说错了 | 每句台词都用对白标记包起来:(S1) says: <d>[English] …</d> |
| 附了参考图,却没点名 | 模型只能猜哪张脸是谁 | 每张图定义一个 <Subject N>,之后一律用标签指代 |
| 每个镜头都写一遍发型和衣服 | 文字盖过参考图,细节跟着变 | 在 retention_analysis 里写一次;镜头里只写角色在做什么 |
| 「4K, ultra-realistic, cinematic, masterpiece」 | 基本没用:这些词既不控制镜头,也不控制光线 | 写清光源、景别和运镜 |
| 用代词,不用标签 | 画面里多出一个人,或者台词安错了人 | 每次都用标签 |
| 在提示词里要求出现字幕或文字 | 画面上的字会重复,或者变成乱码 | 字幕放到剪辑软件里加 |
| 各镜头时长加起来和视频时长对不上 | 动作太赶,或者结尾模型自己编台词 | 每个镜头都标上时间,加起来正好等于你选的时长(4–15 秒) |
语法交给 ✦ 增强,反复生成 0 积分
标签、对白标记、各节名称,写起来就像填表,实际上也确实是在填表。在 HelloGen 的视频生成器里,你只要像给演员讲戏那样把这场戏写出来:有谁、说什么、怎么收尾,再附上角色参考图,按一下 ✦ 增强。选的是 MiniMax H3 时,增强依据的就是这同一份 H3 提示词指南,会把你的描述改写成上面那种参考模式格式:每张图都点了名,台词放进对白标记并带上说话人编号;它在设计上会保留你写的台词原文,不额外加台词;生成前最好再看一眼。增强一次 2 积分,成功才扣。
接下来,这场戏想生成多少次都行。MiniMax H3 Unlimited 包含在 Pro(每月 US$19.90 起)和 Max 套餐里,每条 0 积分,没有每日上限:Pro 每天至少 2 条优先生成,Max 至少 5 条,超出后按标准速度生成。Pro 输出 480p,可以用视频放大工具放大到 2 倍(每 15 秒 2 积分);Max 另含无限次 720p 高清。套餐自带的积分还能用在 MiniMax H3 积分版(原生 2K)、Veo 3.1、Kling 3.0 和 Seedance 上,一集里最关键的那个镜头,值得用它们来做。做带货广告的话,可以看姊妹篇 AI 带货视频提示词。
参考资料
- GitHub 上的 MiniMax-H3 h3-prompt-writing skill——参考模式提示词的六节结构,<Subject N> / <Picture N> / <Audio N> 标签,retention_analysis 的取值,说话人编号,<scenetrans> 和 <cutoff>。
- GitHub 上的 MiniMax-H3 3d-animation-short-generator skill——先做角色卡和场景卡、再出视频,每个镜头最多三个有戏份的角色。
- 本页的视频:2026 年 10 月在 HelloGen 的 MiniMax H3 Unlimited 上以 720p 生成,咖啡馆那场戏的完整提示词见上文。
- HelloGen 自己的 H3 测试,2026 年 9 月:文字和参考图冲突、参考图背景被带进画面、</d> 后面的文字被念出来、台词太短导致模型自编台词、画面里出现文字。
- 相关文章:MiniMax H3 人物乱说话怎么办、AI 带货视频提示词:用 MiniMax H3 做 UGC 种草视频。
常见问题
MiniMax H3 怎么让角色保持一致,每条视频都是同一个人?
每条视频都附同一张参考图,用一句简短的描述把角色定义一次,比如 <Subject 1> is the woman in <Picture 1>;在 retention_analysis 里标为 fully_preserved,之后每个镜头都用这个标签称呼它。镜头里别再写发型和衣服,否则文字会和参考图打架。
MiniMax H3 最多能用几张参考图?
参考模式下最多 9 张,这是 MiniMax 官方给出的上限,HelloGen 的 H3 Unlimited 也支持 9 张(选 720p 时最多 5 张)。但图不是越多越好:只附镜头里真正点了名的那几张,一张图只放一个角色或一个地点。
怎么让角色每一集都是同一个声音?
(S1) 这样的说话人编号只在当前这条视频里有效。给每个角色写一段声音描述,写明年龄、音高、音色、语速和口音,每条视频都一字不差地贴在「says:」前面。用 MiniMax H3 积分版时,还可以附一段 2–15 秒的声音素材作为 <Audio 1>。
MiniMax H3 的 <Subject N> 和 <Picture N> 有什么区别?
<Picture N> 是你上传的图片本身,要把图直接当画面用时就写它,比如某个镜头的首帧。<Subject N> 是从图里取出的对象,可以是一个人、一套衣服或一个地方,镜头里用它来指代。角色属于 Subject:<Subject 2> is the man in <Picture 2>。
MiniMax H3 能做超过 15 秒的戏吗?
单条视频是 4 到 15 秒。更长的戏要分几条来做:每条都结束在一个写明的状态上,下一条从上一条的最后一帧开始,角色和场景的描述一字不差,最后在剪辑软件里拼起来。
MiniMax H3 的角色为什么会乱说话,听不出在说什么?
多半是台词写成了叙述,或者只加了普通引号。把台词放进 H3 的对白标记,带上说话人编号和语言标签,写成 (S1) says: <d>[English] the line.</d>;表演说明放在「says:」前面,别紧跟在 </d> 后面。