AI 带货视频提示词:用 MiniMax H3 做出像达人亲手拍的 UGC 种草视频
 Chywe,HelloGen 产品负责人
一条好的 AI 带货视频要做到三点:画面像达人自己拿手机随手拍的,产品和你店里卖的一模一样,台词听着像朋友在跟你聊天。MiniMax H3(海螺 3.0)一次生成就能做到这三点:拿你的照片当参考图,让人物开口说话,声音和口型同步;英语、葡萄牙语、西班牙语等 H3 支持的语言都能说。简单说:给每张图定义一个 <Subject>,在 retention_analysis 里写明哪些不能变,每句台词都放进 <d>[语言] … </d>。下面逐条讲为什么,最后附一份 15 秒模板。本页两条视频都是在 HelloGen 上用文中的提示词生成的。
✦ 试试 MiniMax H3 Unlimited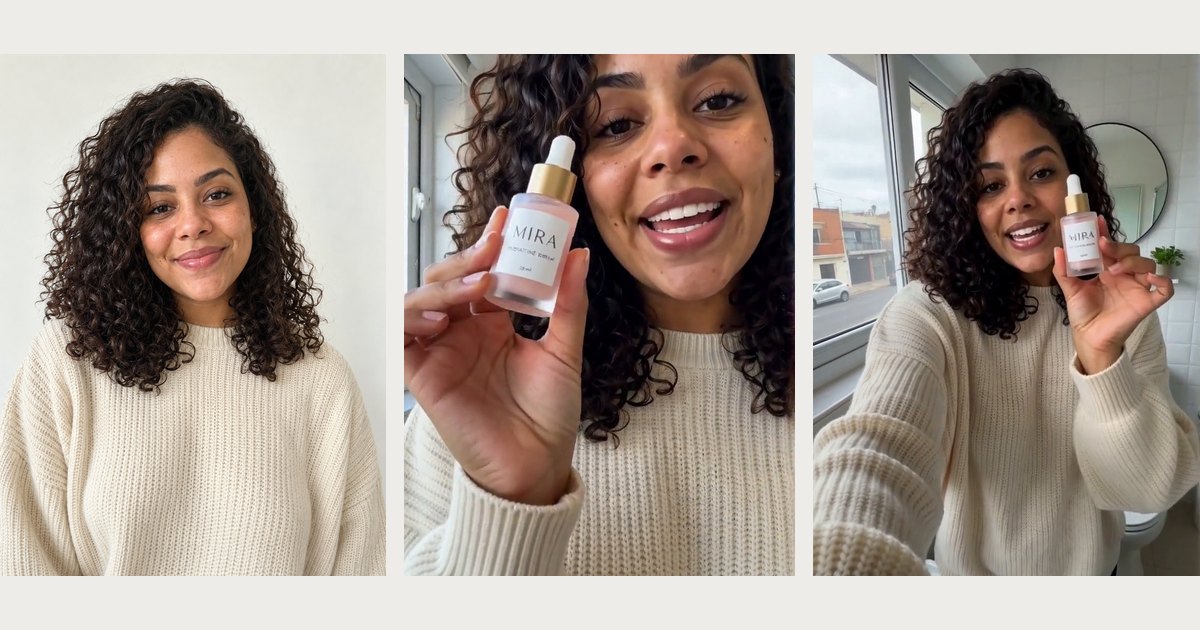
写 UGC 提示词,最容易漏的三件事
附上达人照和产品图,最难的一步就完成了。但提示词要是没写对,这两张图就等于白附。
| 常漏掉的 | 会出什么问题 | 怎么写 |
|---|---|---|
| 说明每张图是什么 | 模型只能自己猜哪张是人、哪张是产品 | <Subject 1> is the woman in <Picture 1>; <Subject 2> is the bottle in <Picture 2> |
| 用一句话写明哪些不能变 | 生成出来的产品变了形状、颜色或标签 | retention_analysis: exact shape, colours and label, fully_preserved |
| 用对白标记把每句台词包起来 | 人物嘴里冒出一串听不懂的话;或者词说对了,却安到了另一个人嘴上 | (S1) says: <d>[Portuguese] …</d> |
两张图,一张管人,一张管货
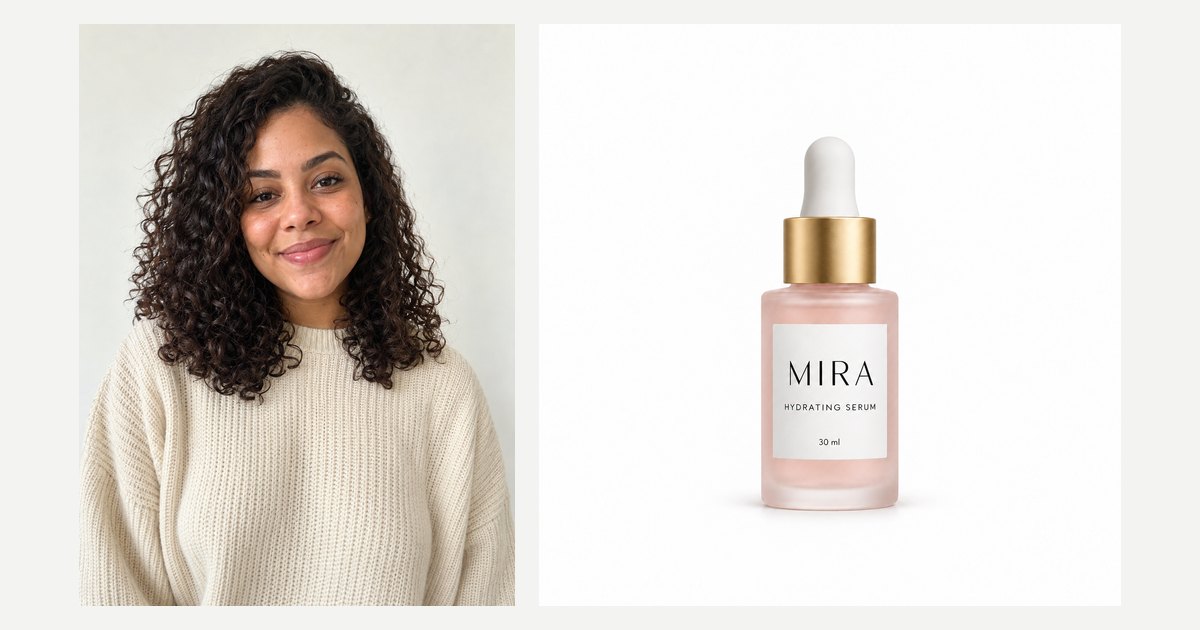
先附达人照,再附产品图,然后在提示词里写明每张图是什么。在 HelloGen 的视频生成器里输入 @ 就能引用这两张图,发给 H3 时会写成 <Picture 1> 和 <Picture 2>。按 MiniMax 官方的参考图语法,每张图都要定义成一个 Subject(主体),后面的分镜里就用这个名字指代它(GitHub 上的 h3-prompt-writing):
<Subject 1> is the woman in <Picture 1>, mid-twenties, dark curly hair, oversized cream sweater. <Subject 2> is the serum bottle in <Picture 2>.
(意思是:<Subject 1> 是 <Picture 1> 里的女生,二十五岁上下,深色卷发,穿一件宽松的奶油色毛衣;<Subject 2> 是 <Picture 2> 里的那瓶精华。)
再守住两条规矩,生成出来的才还是你家的产品:
- 分镜里别再描述产品。 我们测 H3 时发现,文字和图片一冲突,模型就听文字的:一个杯子凭空多了个把手;一件产品变成了银色,因为提示词里写了八遍「银色」;还有一件的 logo 直接没了。在 retention_analysis 里写一句「keeps its exact shape, colours and label」(形状、颜色、标签都保持原样),关于产品,写这一句就够了。
- 只借产品,不借背景。 再加一句「do not reuse the reference’s background」(不要沿用参考图的背景)。我们测试时做过一条新品预告片,没加这句,结果最后一秒,整张白底产品图连背景一起贴进了画面,像在达人胸前挂了块牌子。
照片本身也有讲究。产品图:只放一件产品,居中摆放,纯色背景,标签朝向镜头,画面里不要出现手。达人照:画面里只有一个人,脸要拍得够大,身上穿的就是视频里要穿的那一身。可以参考下面这两张。标签上的字要大、要简单:我们生成的视频里,MIRA 这个品牌名一直看得清,下面那行小字就糊了。
15 秒 UGC 带货视频的节奏表
UGC 带货视频大多是同一个套路:钩子、展示卖点、给出评价、引导下单。用 H3 做,时间怎么分配和套路本身一样重要:每 3 到 4 秒安排一句台词,没人说话的那几秒,也要在提示词里写明没人说话。哪段时间你没交代,模型就会自己编几句台词塞进去。
| 时间 | 镜头 | 画面 | 声音 |
|---|---|---|---|
| 0:00–0:03 | 钩子:半身,前置镜头 | 达人看着镜头,手里拿着产品 | 钩子台词 |
| 0:03–0:08 | 卖点:特写,不露脸 | 最能证明卖点的画面:滴管、质地、气泡、上身效果 | 只有产品发出的声音,写明没人说话 |
| 0:08–0:12 | 反应:脸回到画面 | 她放下产品,先做出反应,再开口 | 一句评价 |
| 0:12–0:15 | 收尾:产品举到脸旁 | 标签朝向镜头,画面稳住 | 顺口带一句下单引导 |
台词要对得上口型,还要说买家的语言
先做动作,再开口。 每句台词都要安排在达人正对镜头、嘴看得清的时候说;动作放在台词之前或之后,做动作时不说话。比如「She takes a sip, lowers the can, then says…」(她喝一口,放下罐子,然后说……),「放下罐子」这一步,就是为了让嘴重新露出来。边喝边说、边吃边说,或者在产品特写上配台词,口型最容易对不上。
对白标记、说话人编号、语言标签,一个都不能少。 <Subject 1>, a woman in her twenties with a bright, quick Brazilian Portuguese voice (S1), says: <d>[Portuguese] Gente, olha a textura desse sérum.</d>(意思是:<Subject 1>,二十多岁的女生,声音明亮、语速偏快,巴西葡萄牙语口音,(S1) 说:「家人们,看看这个精华的质地。」)MiniMax 官方指南的要求是:提示词正文用英文;台词用要说的那种语言原样写;说话人的声音描述(包括口音)写在「says:」前面。
</d> 后面别紧接着写东西。 紧跟在结束标记后面的文字会被念出来:我们就遇到过一段声音描述被一字不差地念成了台词。下一个动作另起一个节拍写,比如新起一句或切到下一个镜头。
数字和功效,只写有依据的。 瓶身上印着 30 ml,台词里才能说 30 ml。产品详情页上找不到依据的功效、成分和数据,一个字都别写进台词。
五种 UGC 形式,各自的关键镜头
结构都一样,变的只是中间的卖点镜头。选哪种形式,取决于买家要先看到什么才会信你。
| 形式 | 靠哪个镜头带货 | 要注意 |
|---|---|---|
| 开箱 | 产品从盒子里拿出来的第一眼 | 视频模型最难处理好的就是胶带、拉链和盒盖。直接从合着的盒子,切到产品已经拿在手里的画面 |
| 测评 / 试吃试喝 | 一个看得见的试用动作:喝一口、在手上抹一道、搅一搅 | 台词放在喝完之后,别边喝边说 |
| 痛点 → 解决 | 先把痛点拍出来,再让产品解决它 | 前后两段必须是同一个人、同一个房间 |
| 使用前后对比 | 同样的构图、同样的光线,前后并排放 | 前后拍法不一样,看起来就像两件不同的产品 |
| 试穿 | 对着镜头转个身,把上身效果亮出来 | 衣服交给照片来定,提示词里别再描述一遍 |
照着改就能用:15 秒 AI 带货视频完整提示词
两张参考图,先达人后产品:在 HelloGen 视频生成器里是 @Image1 和 @Image2,发给 H3 时写成 <Picture 1> 和 <Picture 2>。竖屏 9:16,15 秒。照片、房间和台词换成你自己的,结构不要动。
模板分六段:subject_definitions 定义人、货、场;summary 用一句话概括整条视频;retention_analysis 写哪些必须保持原样;detailed_description 按镜头写画面和台词;overall_soundscape 写环境音;non_diegetic_music 是配乐,N/A 表示不要配乐。
下面模板里三句葡萄牙语台词的意思依次是:「家人们,看我刚收到的这瓶精华。」「超轻薄,不黏腻。」「链接就在下面。」最后一句相当于国内带货常说的「点下方小黄车」。
subject_definitions: <Subject 1> is the woman in <Picture 1>, mid-twenties, dark curly hair, oversized cream sweater. <Subject 2> is the serum bottle in <Picture 2>. <Subject 3> is her bathroom: white tiles, a round mirror, a small plant on the shelf, soft morning light from a window at frame left.
summary: [reference generation] A phone-filmed UGC ad: <Subject 1> shows <Subject 2> to her front camera in <Subject 3>, tries it on the back of her hand and gives a short verdict.
retention_analysis: <Subject 1> (appears in [Shot 1], [Shot 3], [Shot 4]): fully_preserved - face, curly hair and cream sweater are retained. <Subject 2> (appears in [Shot 1], [Shot 2], [Shot 3], [Shot 4]): fully_preserved - exact shape, colours and label, readable whenever it faces the camera. Do not reuse either reference’s background.
detailed_description: Vertical handheld phone footage with slight natural shake, real skin texture, no filters, no on-screen text. [Shot 1] Waist-up, front camera at arm’s length: <Subject 1> faces the lens holding <Subject 2> beside her cheek. <Subject 1>, a woman in her twenties with a bright, quick Brazilian Portuguese voice (S1), says: <d>[Portuguese] Gente, olha esse sérum que chegou.</d> [Shot 2] At 00:03.000, the shot cuts to a close-up of her hands: she squeezes the dropper once onto the back of one hand and spreads the drop with two fingers; it glistens in the window light. No one speaks; only the soft click of the dropper. [Shot 3] At 00:08.000, back to the front camera: she lowers her hand, looks into the lens, and (S1) says: <d>[Portuguese] Super leve, não fica grudando.</d> [Shot 4] At 00:12.000, she lifts <Subject 2> beside her face with the label to the lens; the camera settles, and (S1) says: <d>[Portuguese] O link tá aqui embaixo.</d>
overall_soundscape: A small tiled bathroom with a light echo, the dropper’s click, a soft rub of skin, distant street noise through the window.
non_diegetic_music: N/A
换个市场,只改台词和口音
换市场时,只需重写三句台词,再换掉声音描述里的口音,照片、镜头和时间点都不用动。比如面向西班牙语买家:
<Subject 1>, a woman in her twenties with a bright, quick Latin American Spanish voice (S1), says: <d>[Spanish] Miren el sérum que me llegó.</d> … <d>[Spanish] Súper ligero, no se siente pegajoso.</d> … <d>[Spanish] El link está aquí abajo.</d>
(声音换成拉美西班牙语口音;三句台词依次是:「你们看看我收到的这瓶精华。」「超轻薄,用起来不黏。」「链接就在下面。」)
做英语市场,钩子可以写成 <d>[English] Okay, look what just came in.</d>(「好了,看看我刚收到了什么。」)每个市场用同一组照片各生成一版,就有了好几个语言版本,每一版里都是同一个达人、同一瓶精华。
别冒充真实买家,在 TikTok 上要打 AI 标签
AI 生成的 UGC 素材可以用,但不能冒充真实买家。TikTok 要求创作者给逼真的 AI 生成内容打标签(TikTok 官方公告)。在美国,联邦贸易委员会(FTC)2024 年 8 月公布了关于消费者评价和推荐的最终规则,禁止虚假推荐,其中包括用 AI 生成、冒称出自某个并不存在的人的推荐(FTC 公告)。养成三个习惯,广告就不容易踩线:打开 TikTok 的「AI 生成」标签;让达人以展示产品的身份出镜,不要写成买家在讲自己的使用效果;只说产品详情页能支撑的卖点。TikTok Shop 对挂车视频另有规定,发布前先看一遍最新版本。以上是一般信息,不构成法律建议。
钩子试十版、留一版,每条 0 积分
钩子决定观众会不会往下看,想找到好钩子,最靠谱的办法就是多生成几版来试,H3 Unlimited 就用在这一步。在 HelloGen 的 Pro(每月 US$19.90 起)和 Max 套餐里,MiniMax H3 Unlimited 每条 0 积分,没有每日上限:每天至少有 2 条(Pro)或 5 条(Max)优先出片,超出的部分按标准速度生成。照片和节奏表都不动,只换钩子那句台词,每个版本生成一条;再把台词换成各个市场的语言,各生成一遍。
Pro 生成的是 480p,挑中的那条可以用视频放大工具放大到 2 倍(每 15 秒 2 积分);Max 另外包含无限次 720p 高清。套餐附带的积分也可以用来出最终成片,按积分计费的 MiniMax H3(原生 2K)、Seedance 2.5、Kling 3.0 和 Veo 3.1 都能用。不想花一下午跟这些标签和标记较劲,也可以用大白话把视频描述出来,附上两张照片,点一下 ✦ 增强。它会把你的描述改写成 H3 的参考图格式,它在设计上会保留你写的台词原文,不额外加台词,生成前最好再看一眼。增强一次 2 积分,成功才扣。想用固定角色拍系列短剧,而不只是做一条广告?可以看短剧提示词指南,里面讲了怎么让每一集的长相和声音保持一致。
参考资料
- GitHub 上的 MiniMax-H3 h3-prompt-writing skill——参考图标签、retention_analysis、对白标记、语言标签,以及写在台词前面的说话人描述(含口音)。
- TikTok 官方公告,2024 年 5 月 9 日——要求创作者给逼真的 AI 生成内容打标签。
- FTC,2024 年 8 月——禁止虚假评价和推荐的最终规则,AI 生成的也在其列。
- 本页的视频——2026 年 10 月在 HelloGen 的 MiniMax H3 Unlimited 上生成,720p,提示词即文中所示。
- HelloGen 自己的 H3 测试,2026 年 9 月——文字压过图片、产品图的背景被沿用、</d> 后面的文字被念出来。
- 相关文章:MiniMax H3 短剧提示词指南、MiniMax H3 人物乱说话怎么办。
常见问题
MiniMax H3 能做 UGC 带货视频吗?
能。在参考模式下,给 H3 一张达人照和一张产品图,它能生成 4 到 15 秒的 9:16 竖屏视频,人物用你写台词的那种语言开口说话,声音和口型同步。两张图都定义成 Subject,分镜里别再描述产品。
AI 带货视频里,怎么让产品不走样?
附一张干净的产品图,用 <Subject 2> is the bottle in <Picture 2> 定义它,在 retention_analysis 里标为 fully_preserved,再加一句「do not reuse the reference’s background」。分镜里别写它的颜色、材质或 logo,因为文字和图片一冲突,模型就听文字的。
怎么让 AI 达人说葡萄牙语或西班牙语?
用那种语言写台词,放进 H3 的对白标记,并加上语言标签:(S1) says: <d>[Portuguese] the line.</d>。口音写在「says:」前面的说话人描述里,比如「a bright, quick Brazilian Portuguese voice」(声音明亮、语速快,巴西葡萄牙语口音)。提示词其余部分用英文写。
AI 带货视频做多长合适?
15 秒。一条 15 秒的 MiniMax H3 视频,刚好放得下钩子、看得见的卖点、一句评价和下单引导。想短一点,就缩短卖点镜头,台词别删;想更长,就在剪辑软件里把两条视频拼起来。
TikTok 和 TikTok Shop 允许发 AI 生成的 UGC 视频吗?
允许,但要求创作者给逼真的 AI 生成内容打标签。美国的规定还禁止虚假推荐,把 AI 人设包装成真实买家也算在内。所以要打开 AI 生成标签,让达人展示产品,不编造使用效果。TikTok Shop 对挂车视频另有规定,发布前先查一下最新政策。
台词说完了,达人为什么还在说?
视频长、台词短,空出来的几秒模型会自己填上;紧跟在 </d> 后面的文字也会被念出来。解决办法:每 3 到 4 秒安排一句台词,或者写明哪几秒没人说话;把环境音写出来;描述性的文字都放在「says:」前面。