Prompt MiniMax H3 para novela com IA: mesmo rosto e mesma voz do primeiro ao último capítulo
 Chywe, Head de Produto do HelloGen
Capítulo um: o protagonista tem barba curta e jaqueta verde. Capítulo três: a barba sumiu, a jaqueta virou um casaco cinza e a voz subiu uma oitava. Quem faz novelinha com IA, seja com gente ou com frutas, conhece bem esse drama. O MiniMax H3 consegue manter o personagem de um clipe para o outro (aceita até nove imagens de referência e já gera as falas com sincronia labial), mas só se o prompt estiver escrito do jeito que o modelo entende. Quando o personagem muda, o prompt quase sempre tem um destes três problemas: as imagens estão anexadas, mas nada diz ao modelo qual é qual; as falas ficam fora dos marcadores de fala do H3; ou cada plano descreve o personagem de novo, cada vez de um jeito. Este guia de prompts do MiniMax H3 resolve os três, com base nas regras da própria MiniMax e no que medimos nos nossos testes com o H3. Todos os clipes desta página foram gerados no HelloGen, e o prompt completo da cena do café está mais abaixo.
✦ Experimente o MiniMax H3 Unlimited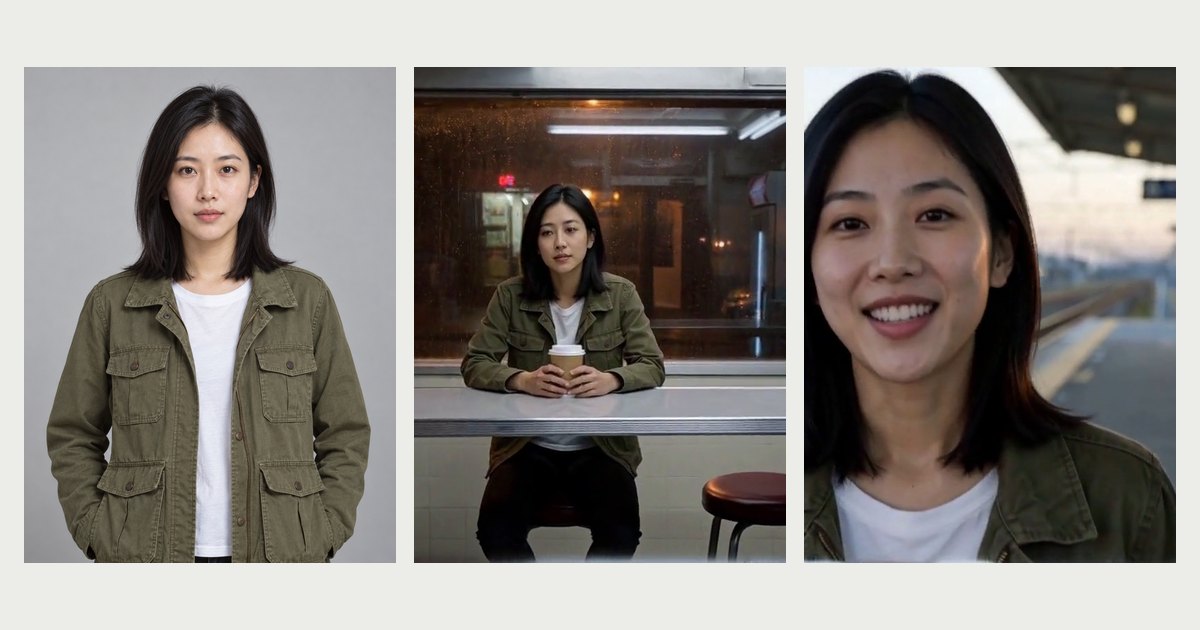
Coloquei imagem de referência. Por que o personagem continua mudando no MiniMax H3?
Resposta curta: anexe a mesma imagem de referência em todos os clipes e vincule essa imagem a um rótulo (<Subject 1> is the woman in <Picture 1>). Diga uma vez só, em retention_analysis, o que precisa ser mantido. Coloque cada fala dentro de <d>…</d> com um ID de falante e cole a mesma descrição de voz em todos os clipes. Os passos abaixo mostram como fazer cada coisa.
Cada clipe é uma geração separada: quando gera o capítulo dois, o H3 não se lembra do capítulo um. Por isso, tudo o que o modelo sabe sobre quem está em cena vem de três fontes, e só delas: a imagem de referência que você anexa, os rótulos do prompt que vinculam essa imagem a um personagem e o texto que você escreve sobre esse personagem. Quando um rosto muda, uma dessas três está faltando ou duas delas se contradizem.
O caso mais comum passa batido: as imagens estão anexadas e o prompt parece pronto, mas nada diz ao modelo qual imagem é qual. Aí os planos voltam a descrever a pessoa em palavras, e o modelo recebe uma segunda descrição de alguém que a foto já mostra. Texto e foto passam a disputar entre si.
| De onde vem a identidade | O que define | Quando dá errado |
|---|---|---|
| A imagem de referência | Rosto, cabelo, corpo, roupa | O modelo inventa uma pessoa nova a cada clipe |
| O rótulo que vincula a imagem ao personagem (<Subject 1> … <Picture 1>) | Qual imagem é qual personagem | Os rostos trocam de dono, ou dois personagens viram um só |
| O texto sobre o personagem | O que ele faz, diz e sente nesta cena | Quando volta a descrever a aparência, o texto passa por cima da imagem e os detalhes mudam |
Passo 1: escale o elenco antes de tudo, com uma ficha por personagem
O fluxo que a própria MiniMax usa para curtas começa aqui, antes de qualquer vídeo: uma ficha de personagem para cada pessoa e uma ficha de cenário para cada locação, só com o lugar, sem ninguém nele (3d-animation-short-generator no GitHub). O motivo vale para qualquer modelo: para manter um rosto, uma imagem funciona melhor do que um parágrafo.
O que faz uma boa referência de personagem no H3:
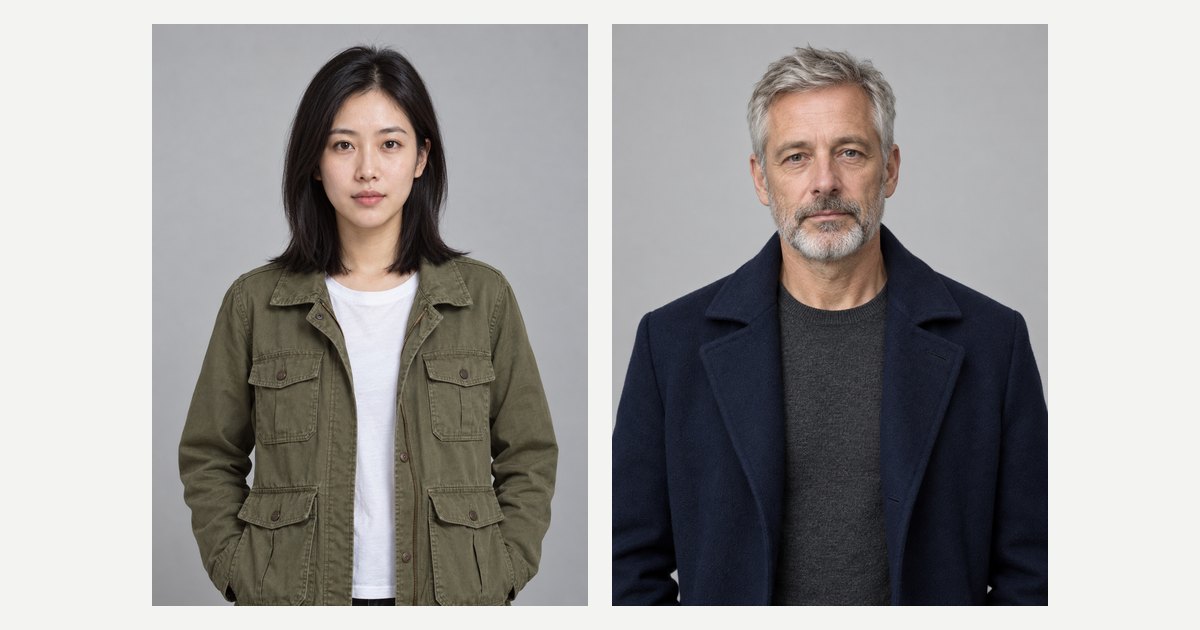
- Um personagem por imagem. Da cintura para cima, de frente para a câmera, fundo liso e luz uniforme, como nos dois retratos abaixo.
- Rosto grande. No H3 Unlimited do HelloGen, cada referência é redimensionada para o tamanho do clipe antes de chegar ao modelo. Um rosto pequeno numa foto em plano aberto, ou numa folha de turnaround lotada de ângulos, chega lá como meia dúzia de pixels. Da cintura para cima, a roupa aparece e o rosto ainda fica grande o bastante.
- A roupa vai na imagem, não no prompt. Se a protagonista usa a jaqueta verde em todos os capítulos, gere a referência dela já de jaqueta verde. Se o figurino mudar no meio da série, faça uma ficha nova em vez de acrescentar uma frase.
- Use o mesmo arquivo na série inteira. Uma imagem um pouco diferente dá uma pessoa um pouco diferente.
Dá para criar o elenco no gerador de imagens grátis do HelloGen, salvar as imagens e anexar sempre os mesmos arquivos em todos os clipes.
Passo 2: vincule cada imagem a um personagem com <Subject N>
O modo de referência do H3 (no gerador do HelloGen, “Referência Omni”) tem rótulos próprios, e é justamente essa a parte que a maioria dos prompts ignora. O guia da MiniMax usa <Picture N> para a imagem em si e <Subject N> para algo extraído dela (uma pessoa, uma roupa, um lugar) que os planos podem citar depois (h3-prompt-writing no GitHub). Para o H3, um personagem é um subject:
<Subject 1> is the young woman in <Picture 1>, with shoulder-length black hair and a green field jacket.
Traduzindo: <Subject 1> é a jovem que aparece na <Picture 1>, de cabelo preto na altura dos ombros e jaqueta militar verde.
Daí em diante, todo plano se refere a ela como “<Subject 1>”, nunca como “she” ou “the girl”: cada rótulo tem um só significado, em todas as seções do prompt. Mantenha curta a frase que identifica o personagem e repita sempre as mesmas palavras. Nos exemplos da própria MiniMax, “the young man in the dark-grey hoodie” se repete plano após plano, sem troca por sinônimos. No HelloGen, você nem precisa escrever o rótulo da imagem: no gerador de vídeo, digite @ e escolha a imagem; o @Image1 chega ao H3 como <Picture 1>.
| Rótulo | Para que serve | Exemplo |
|---|---|---|
| <Subject N> | Um personagem, uma roupa, um objeto ou um lugar extraído de uma referência | <Subject 2> is the man in <Picture 2>, short grey beard, navy wool coat. |
| <Picture N> | A imagem usada como quadro do vídeo, por exemplo o primeiro quadro de um plano | <Picture 3> is the first frame of [Shot 1]. |
| (S1), (S2) | Quem está falando: uma voz, não uma imagem | <Subject 1> (S1) says: <d>[English] You came back.</d> |
Passo 3: diga o que não pode mudar e depois pare de descrever
A terceira seção de um prompt de referência do H3, retention_analysis, é onde você diz o que deve ser mantido e em quais planos cada personagem aparece. A MiniMax define valores fixos para essa seção: fully_preserved, partially_preserved, attribute_transfer, weak_reference (algo como preservar tudo, preservar em parte, transferir só um atributo e referência fraca):
<Subject 1> (appears in [Shot 1], [Shot 3]): fully_preserved - her face, shoulder-length black hair and green field jacket are retained.
Traduzindo: <Subject 1> aparece nos planos 1 e 3 e é preservada por completo: rosto, cabelo preto na altura dos ombros e jaqueta verde.
Foi aqui também que encontramos a causa da maioria das mudanças de personagem que já investigamos. O problema não era falta de descrição, e sim descrição no lugar errado. Nos nossos testes com o H3, quando o prompt pulava esta seção e voltava a descrever, dentro dos planos, o que a referência já mostrava, o texto venceu a imagem em todas as gerações que conferimos: um copo apareceu com uma alça que ele não tem, outro produto saiu prateado porque o texto repetia “prateado” oito vezes, e um terceiro perdeu o logo. Com pessoas acontece o mesmo. Então descreva as características uma vez só, aqui, e deixe a imagem cuidar do resto. Nos planos, escreva o que o personagem faz, não como ele é.
Mais três regras que tiramos das nossas próprias produções:
- Aproveite a pessoa, não a foto inteira. Acrescente “do not reuse the reference’s background” (não reaproveite o fundo da referência). Num dos nossos testes com o H3, uma referência com fundo branco apareceu colada inteira no último segundo, como uma placa.
- Nunca roteirize uma mudança de aparência no meio do clipe. “Her hair comes loose” (o cabelo dela se solta) é uma transição que o modelo não consegue fazer: a imagem fica oscilando entre os dois estados e o rosto começa a virar o de outra pessoa. Se o cabelo está solto, está solto desde o primeiro quadro.
- Escreva só o que valeria qualquer que fosse a foto anexada. Idade, corpo, pele e penteado vêm da referência. Cabelo molhado, manga rasgada e lama na bota fazem parte da cena: isso você pode escrever.
Passo 4: uma voz que não muda, com um ID por falante e sempre a mesma descrição
Novela é metade diálogo, e o H3 fala: imagem e som estéreo saem da mesma geração. Duas coisas definem se o personagem certo vai dizer as falas certas, com uma voz que dá para reconhecer.
Marcadores e IDs. Cada fala vai entre <d> e </d>, com uma tag de idioma, e cada personagem que fala recebe um ID fixo, como (S1) ou (S2), antes da fala: <Subject 1> (S1) says: <d>[English] You said you’d call.</d> Fala escrita em prosa é a causa mais comum daquele som que parece fala, mas não tem palavra nenhuma. Nosso guia sobre o H3 falando palavras sem sentido (em inglês) mostra o que medimos e traz sete correções.
A mesma voz em todos os capítulos. O ID de falante só vale dentro de um clipe. Como o H3 não guarda nada da geração anterior, o (S1) do capítulo dois é uma voz nova, a menos que você a descreva do mesmo jeito. Escreva uma descrição de voz para cada personagem (idade, tom, timbre, ritmo, sotaque), coloque-a antes de “says:” na primeira fala do personagem em cada clipe e cole o texto palavra por palavra em todos os clipes:
<Subject 1>, a woman in her late twenties with a low, slightly husky voice and an unhurried pace (S1), says: <d>[English] …</d>
Traduzindo: <Subject 1>, uma mulher de quase trinta anos, de voz grave e levemente rouca, que fala sem pressa (S1), diz: …
Quer as falas em português? Escreva-as em português com a tag [Portuguese] e coloque o sotaque na descrição da voz, por exemplo “a Brazilian Portuguese voice”. O restante do prompt continua em inglês, como pede o guia da MiniMax. Nosso guia de anúncios UGC no H3 tem um clipe inteiro falado em português.
Na versão do MiniMax H3 cobrada em créditos, também dá para anexar um áudio de voz de 2 a 15 segundos e declarar <Audio 1> is the voice-timbre reference for <Subject 1> (S1) (o <Audio 1> é a referência de timbre de <Subject 1>), recurso previsto no guia da MiniMax. O H3 Unlimited aceita só imagens; nele, quem mantém a voz é a descrição escrita, por isso ela precisa ser idêntica em todos os clipes. A descrição leva o H3 para o mesmo tipo de voz: espere uma voz bem parecida, não um clone.
Passo 5: escreva a cena plano a plano
O H3 consegue fazer cortes dentro de um mesmo clipe. No formato da MiniMax, o primeiro plano é [Shot 1], sem marcação de tempo, e cada plano seguinte começa pelo momento do corte: [Shot 2] At 00:05.000, the shot cuts to… (aos 5 segundos, corta para…). Todo corte precisa trazer algo novo: um rosto, um lugar, uma mudança na situação. Se só muda a distância, mova a câmera em vez de cortar. Estas são as regras que deixam uma cena a dois fácil de acompanhar:
| Regra | Por quê |
|---|---|
| Um personagem fala por plano, de frente para a câmera, com a boca visível | A sincronia labial se mantém enquanto o rosto aparece. Uma fala dita de cabeça virada ou num plano aberto sai dessincronizada ou vai parar na boca da pessoa errada. |
| Primeiro a ação, depois a fala | “She sets the cup down, then says…” (ela põe o copo na mesa e diz…). Uma fala no meio de um gole ou de um abraço esconde a boca. |
| No máximo três personagens com ação ou fala no mesmo plano | É o limite do próprio checklist de curtas da MiniMax. |
| Posições do ponto de vista da câmera: “frame left” (à esquerda do quadro), “enters frame right” (entra pela direita do quadro) | “To her left” (à esquerda dela) é ambíguo; a referência da câmera não deixa dúvida. |
| Indique a altura quando duas pessoas aparecem juntas no quadro: em números ou, pelo menos, a diferença | “182 cm and 160 cm” ou “a head taller” (uma cabeça mais alto). Sem nenhuma das duas indicações, o modelo tende a deixar os dois com a mesma altura. |
| Uma fala a cada 3–4 segundos, ou diga em quais segundos há silêncio | Uma fala curta num clipe longo é um convite para o modelo encher linguiça com falas que você não escreveu. |
| Indicações de interpretação antes de “says:”, nunca logo depois de </d> | O que vem logo depois do marcador de fechamento é lido em voz alta. |
Passo 6: amarre a história de um clipe para o outro
O H3 gera de 4 a 15 segundos por vez, então um capítulo é feito de vários clipes emendados num editor. Se as emendas vão aparecer ou não, isso se decide antes de gerar:
- Termine cada clipe numa situação descrita com todas as letras, como “ends with <Subject 1> holding the letter, the door open behind her” (termina com <Subject 1> segurando a carta, com a porta aberta atrás dela), e comece o clipe seguinte exatamente nessa situação.
- Amarre cada mudança que só acontece uma vez. Nas nossas produções com vários planos, o erro de continuidade mais comum não era o modelo inventar coisas, e sim o próprio prompt se contradizer: uma porta que abre no plano dois e abre de novo no plano cinco, um cinto de segurança desafivelado duas vezes. Liste o que muda (a porta, o casaco, quem senta onde) e escreva quantas vezes e quando: “the door opens exactly once, in [Shot 2], and stays open” (a porta abre uma única vez, no [Shot 2], e fica aberta).
- Mesmo cenário, mesmas palavras. Descreva cada locação uma vez, cole exatamente o mesmo texto em todos os clipes que a usam e diga também o que não aparece ali, como “no other people, no signage” (mais ninguém, nenhuma placa). Fundos inventados pelo modelo são uma causa comum de diferença entre um plano e outro.
- Use o último quadro como ponto de partida. Exporte o quadro final de um clipe e comece o próximo a partir dele: o H3 Unlimited aceita um primeiro quadro e tem o modo Primeiro e último quadro justamente para isso. No modo de referência, o guia da MiniMax também permite que uma imagem sirva de quadro (“<Picture 3> is the first frame of [Shot 1]”) enquanto as outras definem os personagens.
Quando uma fala atravessa um corte, a MiniMax põe <scenetrans> no ponto em que ela é interrompida e de novo onde ela continua no plano seguinte, e diz que o áudio segue sem quebra pelo corte. Já <cutoff> marca a fala que o fim do clipe corta no meio.
Uma cena completa de 15 segundos, pronta para copiar
Duas referências anexadas, primeiro o retrato da mulher e depois o do homem. No gerador do HelloGen, elas viram @Image1 e @Image2 e chegam ao H3 como <Picture 1> e <Picture 2>. São três planos, duas vozes e um coração que amolece. Troque o elenco, o lugar e as falas pelos seus e mantenha a estrutura.
Como o prompt foi montado: os rótulos vinculam os dois retratos aos personagens; retention_analysis mantém rostos e roupas sem repeti-los nos planos; cada plano tem um só falante, de frente para a câmera; toda ação vem antes da fala; e cada voz é descrita uma vez, com palavras que você pode colar sem mudar nada no próximo capítulo.
A cena, em português: num pequeno café de estação, à noite, ela espera há quarenta minutos. Ele entra com os ombros molhados de chuva, e ela solta: “Você está quarenta minutos atrasado.” Ele explica: “O último trem foi cancelado. Vim a pé.” Ela fica olhando para ele, põe o copo de papel no balcão, empurra na direção dele e diz: “Senta. Ainda está quente.”
subject_definitions: <Subject 1> is the young woman in <Picture 1>, shoulder-length black hair, green field jacket. <Subject 2> is the man in <Picture 2>, short grey beard, navy wool coat. <Subject 3> is a small station café at night: one counter, three stools, rain on the front window.
summary: [reference generation] <Subject 1> has been waiting in <Subject 3>; <Subject 2> arrives late, and she decides to let him stay. Three shots, 15 seconds.
retention_analysis: <Subject 1> (appears in [Shot 1], [Shot 3]): fully_preserved - face, shoulder-length black hair and green field jacket are retained. <Subject 2> (appears in [Shot 2], [Shot 3]): fully_preserved - face, short grey beard and navy wool coat are retained. Do not reuse either reference’s background.
detailed_description: Live-action, naturalistic drama, cool fluorescent light inside, warm street light through the rain-streaked window. [Shot 1] A medium shot from across the counter: <Subject 1> sits on the middle stool facing the camera, both hands around a paper cup. The camera pushes in slowly. She looks up toward the door, and <Subject 1>, a woman in her late twenties with a low, slightly husky voice and an unhurried pace (S1), says: <d>[English] You’re forty minutes late.</d> [Shot 2] At 00:05.000, the shot cuts to the doorway: <Subject 2> steps in from frame right with rain on his shoulders and stops, facing the camera. <Subject 2>, a man in his fifties with a deep, quiet voice (S2), says: <d>[English] The last train was cancelled. I walked.</d> [Shot 3] At 00:10.000, an over-the-shoulder shot from behind <Subject 2>, who stands at frame right, a head taller; <Subject 1> faces the camera from her stool at frame left. She studies him, sets the cup down and slides it toward him, then <Subject 1> (S1) says: <d>[English] Sit down. It’s still warm.</d>
overall_soundscape: Rain on the window, the low hum of a drinks fridge, the door’s bell once at 00:05, wet footsteps, a paper cup sliding on laminate.
non_diegetic_music: N/A
Os erros mais comuns (e como corrigir)
A maioria das cenas que desandam se explica por poucos hábitos, e cada um se corrige com uma linha.
| O erro | O que acontece | Como corrigir |
|---|---|---|
| Falas entre aspas ou em prosa | Som que parece fala, palavras erradas | Coloque cada fala nos marcadores: (S1) says: <d>[English] …</d> |
| Referências anexadas, mas nunca nomeadas | O modelo chuta qual rosto é de quem | Defina um <Subject N> para cada imagem e chame cada um pelo rótulo |
| Cabelo e roupa descritos em cada plano | O texto passa por cima da imagem e os detalhes mudam | Descreva uma vez só, em retention_analysis; nos planos, só o que o personagem faz |
| “4K, ultra-realistic, cinematic, masterpiece” | Nada de útil: essas palavras não dirigem câmera nem luz | Diga qual é a fonte de luz, o enquadramento e o movimento de câmera |
| Pronomes no lugar dos rótulos | Aparece uma segunda pessoa, ou as falas trocam de boca | Use sempre o rótulo |
| Legendas ou texto na tela pedidos no prompt | Texto duplicado e embaralhado na tela | Adicione as legendas no editor |
| Tempos que não fecham com a duração do clipe | Ação atropelada ou fala inventada no final | Marque o tempo de cada plano; a soma tem que bater com os 4–15 s que você escolheu |
Deixe a sintaxe com o ✦ Melhorar e refaça por 0 créditos
Se rótulos, marcadores e nomes de seção parecem burocracia, é porque são. No gerador de vídeo do HelloGen, escreva a cena do jeito que você contaria para alguém (quem está nela, o que diz, como termina), anexe as fichas dos personagens e clique em ✦ Melhorar. Com o MiniMax H3, ele reescreve sua ideia no formato de referência mostrado acima, seguindo o mesmo guia de prompts do H3: imagens nomeadas e falas dentro dos marcadores, com IDs de falante. O botão foi feito para manter o que você escreveu, sem acrescentar falas; mesmo assim, revise o resultado antes de gerar. Custa 2 créditos e só é cobrado se der certo.
Depois, gere a cena quantas vezes precisar. O MiniMax H3 Unlimited vem nos planos Pro (a partir de US$ 19,90 por mês) e Max, a 0 créditos por clipe e sem limite diário: no mínimo 2 clipes prioritários por dia no Pro e 5 no Max, e velocidade padrão depois disso. O Pro gera em 480p, e o upscaler de vídeo dobra a resolução de um clipe por 2 créditos a cada 15 segundos; o Max acrescenta 720p HD ilimitado. Com os créditos do plano, você também usa a versão do MiniMax H3 cobrada em créditos, em 2K nativo, além de Veo 3.1, Kling 3.0 e Seedance. Vale a pena para a cena de maior impacto do capítulo. Se a sua cena tem cara de anúncio, veja o nosso outro guia, sobre anúncios UGC de produto no H3.
Fontes
- Skill h3-prompt-writing do MiniMax-H3 no GitHub — as seis seções do modo de referência, os rótulos <Subject N> / <Picture N> / <Audio N>, os valores de retenção, os IDs de falante, <scenetrans> e <cutoff>.
- Skill 3d-animation-short-generator do MiniMax-H3 no GitHub — fichas de personagem e de cenário antes do vídeo, no máximo três personagens importantes por plano.
- Os clipes desta página — gerados no MiniMax H3 Unlimited do HelloGen em 720p, em outubro de 2026; o prompt completo da cena do café está mais acima.
- Testes do próprio HelloGen com o H3, setembro de 2026 — texto versus imagem, fundo da referência reaproveitado, texto depois de </d>, falas curtas que fazem o modelo inventar fala, texto na tela.
- Relacionados: Por que o MiniMax H3 fala palavras sem sentido e como corrigir (em inglês) e Prompts de anúncios UGC com IA no MiniMax H3.
Perguntas frequentes
Como manter o mesmo personagem em todos os clipes do MiniMax H3?
Anexe a mesma ficha de referência em todos os clipes e defina o personagem uma vez, com <Subject 1> is the woman in <Picture 1> e uma frase curta que o identifique. Depois, marque-o como fully_preserved em retention_analysis e chame-o pelo rótulo em todos os planos. Não volte a descrever cabelo nem roupa nos planos: o texto passa a disputar com a imagem.
Quantas imagens de referência o MiniMax H3 aceita?
Até nove no modo de referência. É o limite da MiniMax e também o que o H3 Unlimited do HelloGen aceita (cinco quando você gera em 720p). Mais imagens não quer dizer resultado melhor: envie só as que os seus planos realmente citam, com um personagem ou um lugar por imagem.
Como deixar a voz do personagem igual em todos os capítulos?
Um ID de falante como (S1) só vale para um clipe. Escreva uma descrição de voz para cada personagem (idade, tom, timbre, ritmo, sotaque) e cole-a palavra por palavra antes de “says:” em todos os clipes. Na versão do MiniMax H3 cobrada em créditos, você também pode anexar um áudio de voz de 2 a 15 segundos como <Audio 1>.
Qual a diferença entre <Subject N> e <Picture N> no MiniMax H3?
<Picture N> é a imagem enviada em si, usada diretamente quando serve de quadro, como o primeiro quadro de um plano. <Subject N> é algo extraído de uma imagem (uma pessoa, uma roupa, um lugar) a que os planos se referem. Um personagem é um subject: <Subject 2> is the man in <Picture 2>.
O MiniMax H3 consegue fazer uma cena com mais de 15 segundos?
Cada clipe dura de 4 a 15 segundos. Para uma cena mais longa, termine cada clipe numa situação bem definida, comece o próximo pelo último quadro do anterior, descreva personagens e cenário sempre com as mesmas palavras e junte os clipes num editor.
Por que o meu personagem do MiniMax H3 fala palavras sem sentido?
Geralmente porque a fala foi escrita em prosa ou só entre aspas. Coloque-a dentro dos marcadores de fala do H3, com um ID de falante e uma tag de idioma — (S1) says: <d>[English] the line.</d> — e deixe as indicações de interpretação antes de “says:”, nunca logo depois de </d>.